AWS Aurora의 커스텀 엔드포인트를 활용한 효율적인 데이터베이스 운영 가이드
AWS Aurora는 클러스터 안에 여러 DB 인스턴스를 두고, 애플리케이션이 사용할 DNS 주소를 엔드포인트로 제공합니다. 이 글에서는 커스텀 엔드포인트로 내부 조회용 인스턴스와 서비스 읽기 인스턴스를 나눠, 별도 SQL Proxy 없이 연결 대상을 분리하는 방법을 정리합니다.
본문의 생성·변경 예제는 같은 리전의 Aurora 클러스터를 대상으로 합니다. 리전 ap-northeast-2와 클러스터·인스턴스·엔드포인트 이름은 실제 환경에 맞춰 바꿉니다. 기존 엔드포인트가 있다면 새로 생성하는 절차 대신 타입과 멤버 설정을 확인하는 절차를 사용합니다.
1. 커스텀 엔드포인트란?
커스텀 엔드포인트는 Aurora 클러스터 안에서 직접 고른 DB 인스턴스 그룹을 하나의 엔드포인트로 묶는 기능입니다. 연결이 들어오면 Aurora가 그룹 안의 인스턴스 중 하나를 골라 처리합니다. AWS 콘솔과 한국어 문서에서는 사용자 지정 엔드포인트라고 표기합니다.
예전에는 같은 효과를 내려고 CNAME으로 DNS 별칭을 만들어 두는 방식을 썼습니다. 커스텀 엔드포인트를 쓰면 클러스터가 커지거나 줄어들 때마다 CNAME 레코드를 손보지 않아도 되고, TLS/SSL 연결도 그대로 쓸 수 있습니다.
1.1. Aurora 엔드포인트 네 종류
| 엔드포인트 | 연결 대상 | 쓰임 |
|---|---|---|
| 클러스터(writer) | 프라이머리 인스턴스 | DDL·DML, 쓰기 작업 |
| 리더 | Aurora 복제본 전체 | 읽기 전용 쿼리, 연결 분산 |
| 커스텀 | 직접 고른 인스턴스 그룹 | 용량·설정이 다른 인스턴스 분리 |
| 인스턴스 | 특정 인스턴스 하나 | 진단과 튜닝 |
클러스터에는 DDL과 DML을 처리하는 프라이머리 인스턴스 하나와, 읽기 전용 쿼리를 받는 Aurora 복제본을 최대 15개까지 둘 수 있습니다. 커스텀 엔드포인트로 그룹을 나눠 쓰기 시작하면 그 클러스터의 리더 엔드포인트는 보통 쓰지 않습니다.
기본 리더 엔드포인트는 reader가 하나도 없으면 writer에 연결됩니다. READER 타입 커스텀 엔드포인트에는 같은 writer 대체 연결을 기대하면 안 됩니다. 연결 가능한 reader가 그룹에 남아 있는지 따로 확인해야 합니다.12
1.2. 주요 특징
- 프로비저닝 클러스터와 Aurora 서버리스 클러스터 모두, 클러스터당 커스텀 엔드포인트를 5개까지 만들 수 있습니다.
- 멤버를 지정하는 방식은 정적 목록(static list)과 제외 목록(exclusion list) 두 가지이고, 한 엔드포인트는 둘 중 하나만 가집니다.
- 엔드포인트 이름은 최대 63자입니다. 같은 리전 안에서 다른 클러스터와 이름을 겹쳐 쓸 수 없습니다.
- 엔드포인트에는 타입이 있습니다. Aurora 사용자 가이드는 현재 쓸 수 있는 타입을 READER와 ANY로 적습니다. 콘솔에서 만든 엔드포인트는 모두 ANY이고, 타입을 지정하거나 바꾸려면 AWS CLI나 RDS API를 써야 합니다.2
1.3. 연결이 분산되는 방식
커스텀 엔드포인트는 세션을 중계하는 프록시가 아닙니다. DNS가 그룹 안 인스턴스 중 하나의 IP 주소를 무작위로 돌려주는 방식으로 연결을 분산합니다. ANY 타입이면 연결이 멤버 인스턴스에 같은 확률로 배정되고, 라이터도 ANY 타입의 멤버가 될 수 있으므로 쓰기 인스턴스로 연결이 갈 수 있습니다. 읽기 인스턴스만 받게 하려면 타입을 READER로 지정합니다.
- 그룹 안의 인스턴스 하나가 응답하지 못하면, 사용 가능한 다른 대상이 있을 때 새 연결을 그 대상으로 보낼 수 있습니다. 이미 열린 연결의 실행 중 쿼리까지 다른 인스턴스로 옮겨 주는 기능은 아닙니다.
- 응답하지 못하는 인스턴스도 멤버에서 빠지지는 않습니다. 중지·재부팅·비정상 상태에서도 멤버로 남고, 다시 사용 가능해질 때까지 그 인스턴스로 연결되지 않습니다.
- 멤버를 추가하거나 제거해도 해당 인스턴스에 이미 열려 있는 연결은 끊기지 않습니다.2
- AWS 문서는 엔드포인트 단위의 DNS 전파 시간이나 초당 연결 수 상한을 제시하지 않습니다. 동시 연결 수는 엔드포인트가 아니라 각 인스턴스의
max_connections에 걸립니다.
2. 내부 조회용 인스턴스와 서비스 읽기 인스턴스 그룹 설정
2.1. 인스턴스 생성
먼저 Aurora 클러스터 안에 다음 용도의 인스턴스들을 만듭니다.
내부 조회용 인스턴스 (devops-aurora-test-instance-3)
- 데이터 분석 및 내부 보고서 생성용
- 대용량 조회 배치
- BI 도구 연동
- ETL의 읽기·추출 단계
서비스 읽기 인스턴스 (devops-aurora-test-instance-1, devops-aurora-test-instance-2)
- 실시간 사용자 요청 처리
- API 서비스 지원
- 빠른 응답이 필요한 조회 작업
이 예제에서 초기 writer는 1번, reader는 2번과 3번입니다. 서비스 그룹의 후보에 1번이 있더라도 READER 타입에서는 writer인 동안 연결 대상이 아닙니다. INSERT·UPDATE·DDL을 수행하는 ETL 적재 단계나 운영 배치는 writer 엔드포인트로 분리합니다.3
인스턴스 타입 권장사항
- 분석용 인스턴스: 메모리 최적화 인스턴스
- 서비스용 인스턴스: 범용 인스턴스
한 엔드포인트에 묶인 인스턴스는 어느 쪽으로 연결이 가도 성능이 같아야 하므로, 같은 그룹 안에서는 인스턴스 클래스와 파라미터 그룹을 맞추는 편이 좋습니다.
NOTE — 분석용 인스턴스에서 Aurora MySQL 병렬 쿼리를 쓸 계획이라면 인스턴스 클래스가
db.r*여야 하고, db.t2·db.t3에서는 쓸 수 없습니다. 병렬 쿼리는 버퍼 풀을 채우지 않으므로 같은 쿼리를 반복해도 I/O 비용이 그대로 발생합니다. Aurora I/O-Optimized 스토리지 구성에서는 병렬 쿼리를 지원하지 않습니다.
여기에서는 동일한 사양으로 3번을 내부 조회용(ETL 및 분석 등), 1, 2번을 서비스로 구성했습니다.
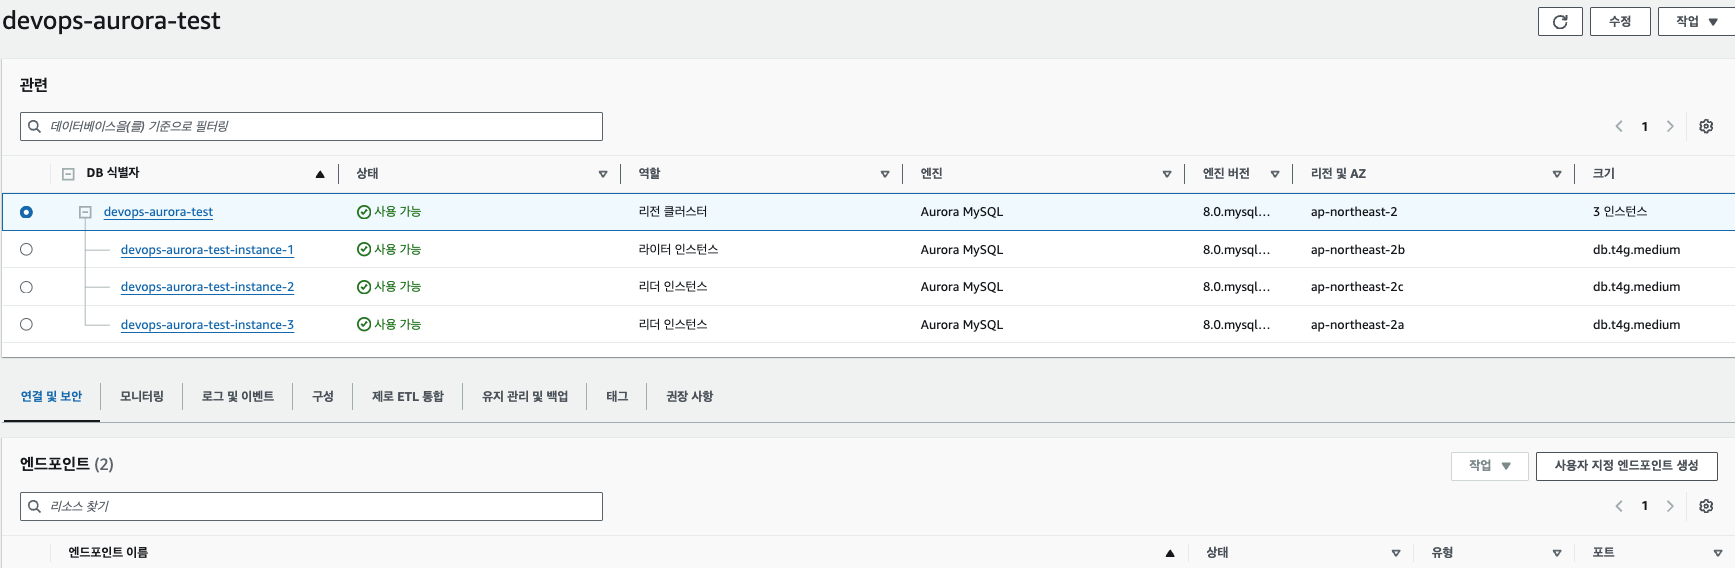
2.2. AWS Aurora 커스텀 엔드포인트 생성 가이드
콘솔을 이용한 생성 방법
콘솔에서는 Attach future instances added to this cluster 체크박스가 멤버 지정 방식을 결정합니다. 체크를 비우면 화면에서 고른 인스턴스만 담는 정적 목록이 되고, 체크하면 고르지 않은 인스턴스만 빼는 제외 목록이 됩니다. 정적 목록으로 만든 엔드포인트에는 나중에 추가된 복제본이 들어오지 않고, 제외 목록으로 만든 엔드포인트에는 자동으로 들어옵니다.
-
AWS Management Console에서 Aurora 클러스터 선택
-
Endpoints 탭으로 이동
-
Create Custom Endpoint 버튼 클릭
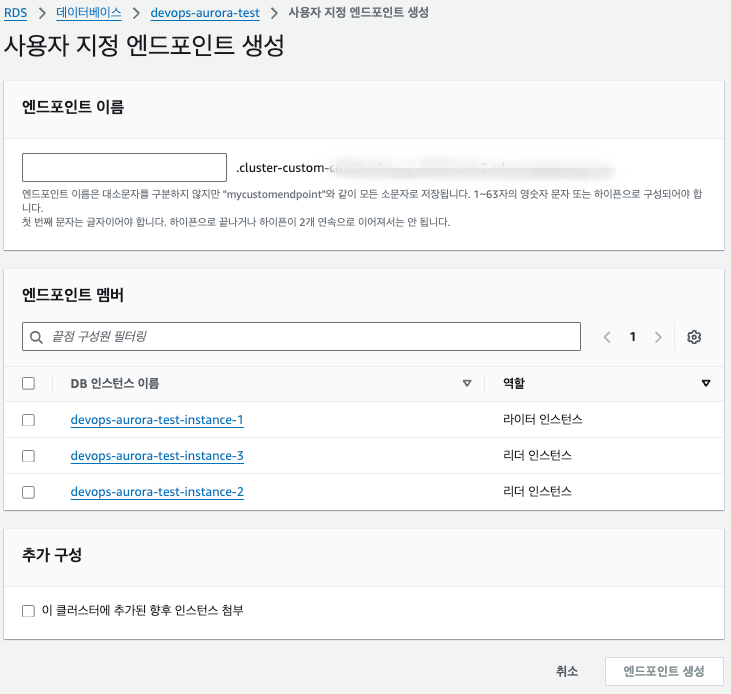
- 서비스 읽기용 커스텀 엔드포인트 설정
- 엔드포인트 이름 지정
- 서비스 읽기 인스턴스 선택
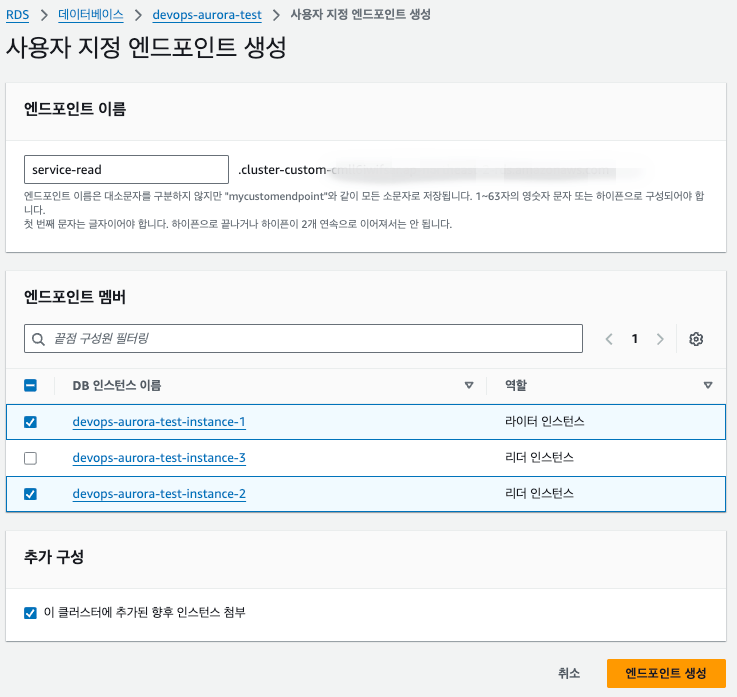
- 내부 조회용 커스텀 엔드포인트 설정
- 엔드포인트 이름 지정
- 내부 조회용 인스턴스 선택
- 생성된 커스텀 엔드포인트 확인
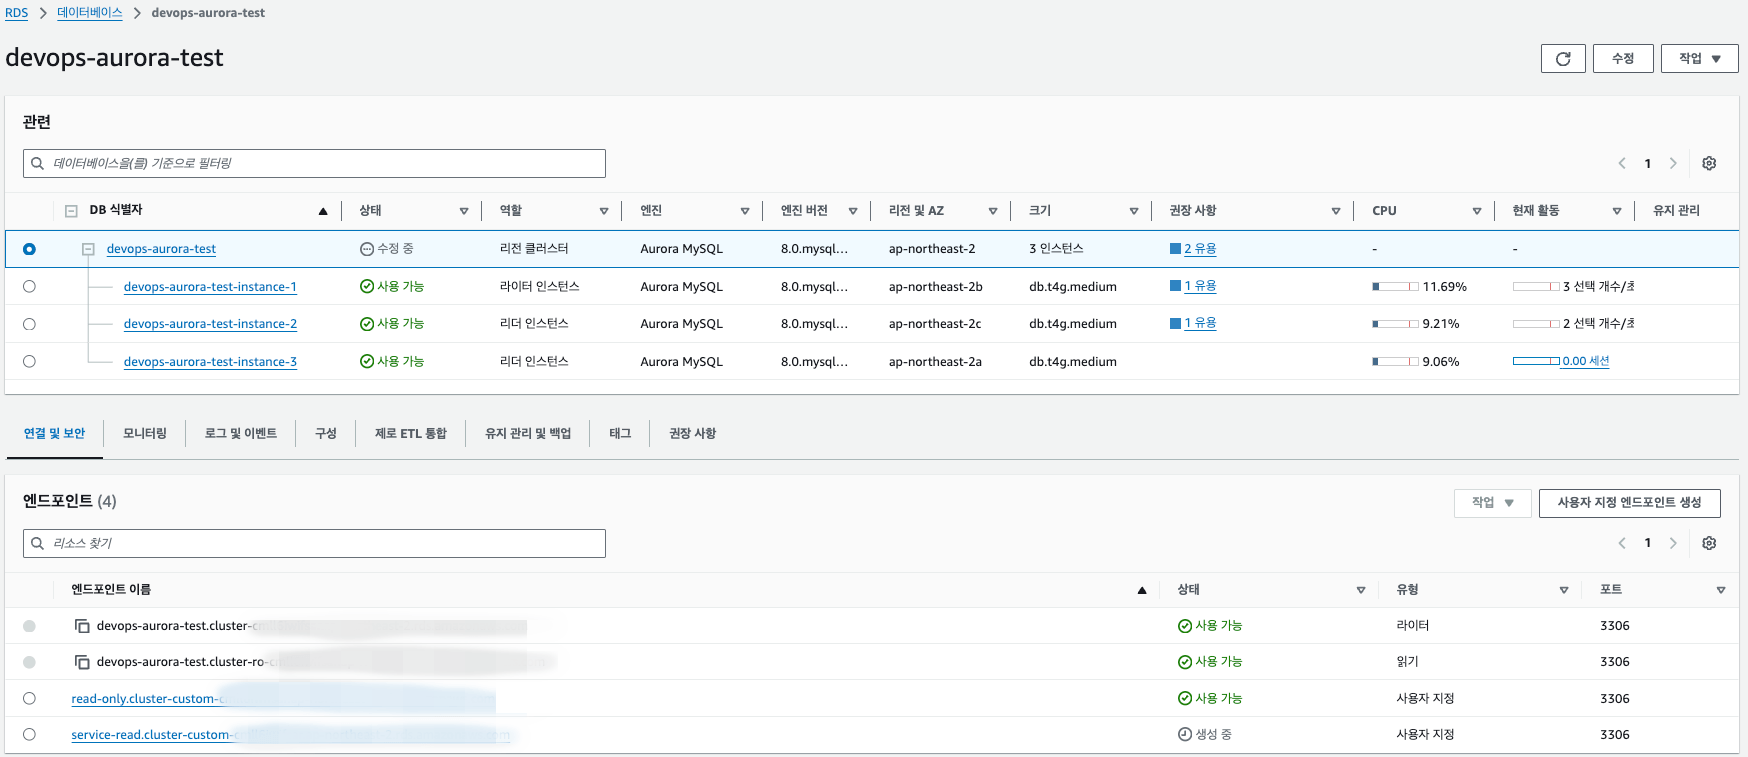
다음 단계 전에 두 엔드포인트를 READER 타입으로 변경합니다. 콘솔 생성 직후에는 ANY이므로 이름에 read-only를 넣거나 reader를 선택한 것만으로 역할 변경 시의 동작까지 정해지지 않습니다. 아래의 멤버·페일오버 설명은 이 전환을 마친 상태를 전제로 합니다.24
aws rds modify-db-cluster-endpoint \
  --region ap-northeast-2 \
  --db-cluster-endpoint-identifier read-only \
  --endpoint-type READER

aws rds modify-db-cluster-endpoint \
  --region ap-northeast-2 \
  --db-cluster-endpoint-identifier service-read \
  --endpoint-type READER
변경 요청의 응답이 modifying이면 완료된 것이 아닙니다. 다음 조회에서 해당 엔드포인트의 Status=available, CustomEndpointType=READER를 확인합니다.5
aws rds describe-db-cluster-endpoints \
  --region ap-northeast-2 \
  --db-cluster-identifier devops-aurora-test \
  --query "DBClusterEndpoints[?EndpointType=='CUSTOM'].{Name:DBClusterEndpointIdentifier,Type:CustomEndpointType,Status:Status,Address:Endpoint,Static:StaticMembers,Excluded:ExcludedMembers}" \
  --output json
EndpointType=CUSTOM은 엔드포인트의 종류이고, 역할 필터는 CustomEndpointType입니다. 정적·제외 목록은 설정된 목록이므로, 이것만으로 현재 접속 가능한 인스턴스가 모두 정상인지까지 판단하지 않습니다. 기존 연결도 자동 교체되지 않으므로 마지막에는 새 연결로 접속 대상을 확인합니다.
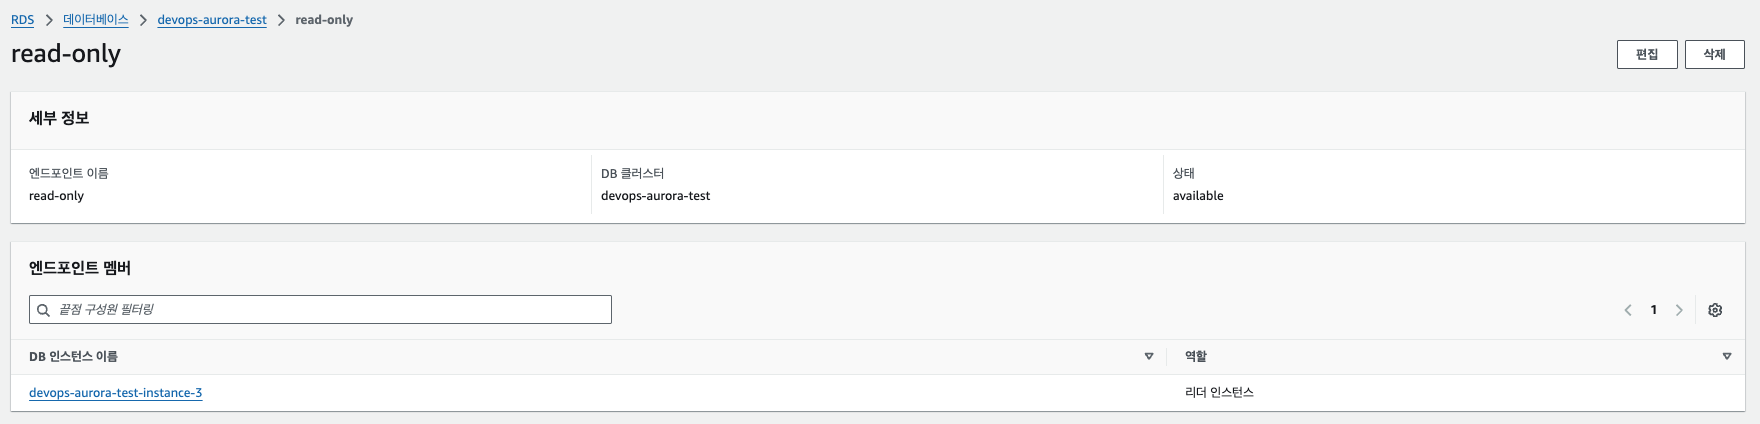
- Read-Only 커스텀 엔드포인트를 확인해보면 3번 인스턴스만 있는 것을 확인할 수 있습니다. 정적 목록으로 만들었기 때문에 앞으로 인스턴스를 추가해도 이 엔드포인트의 멤버는 그대로입니다.
READER전환 후 초기 Service-read의 연결 대상은 2번입니다. 1번은 writer이고 3번은 제외 목록에 있기 때문입니다. 앞으로 추가되는 인스턴스는 제외 목록에 없고 reader이면 연결 대상이 됩니다. Aurora Auto Scaling이 붙인 복제본도 같은 멤버 지정 규칙을 따릅니다.
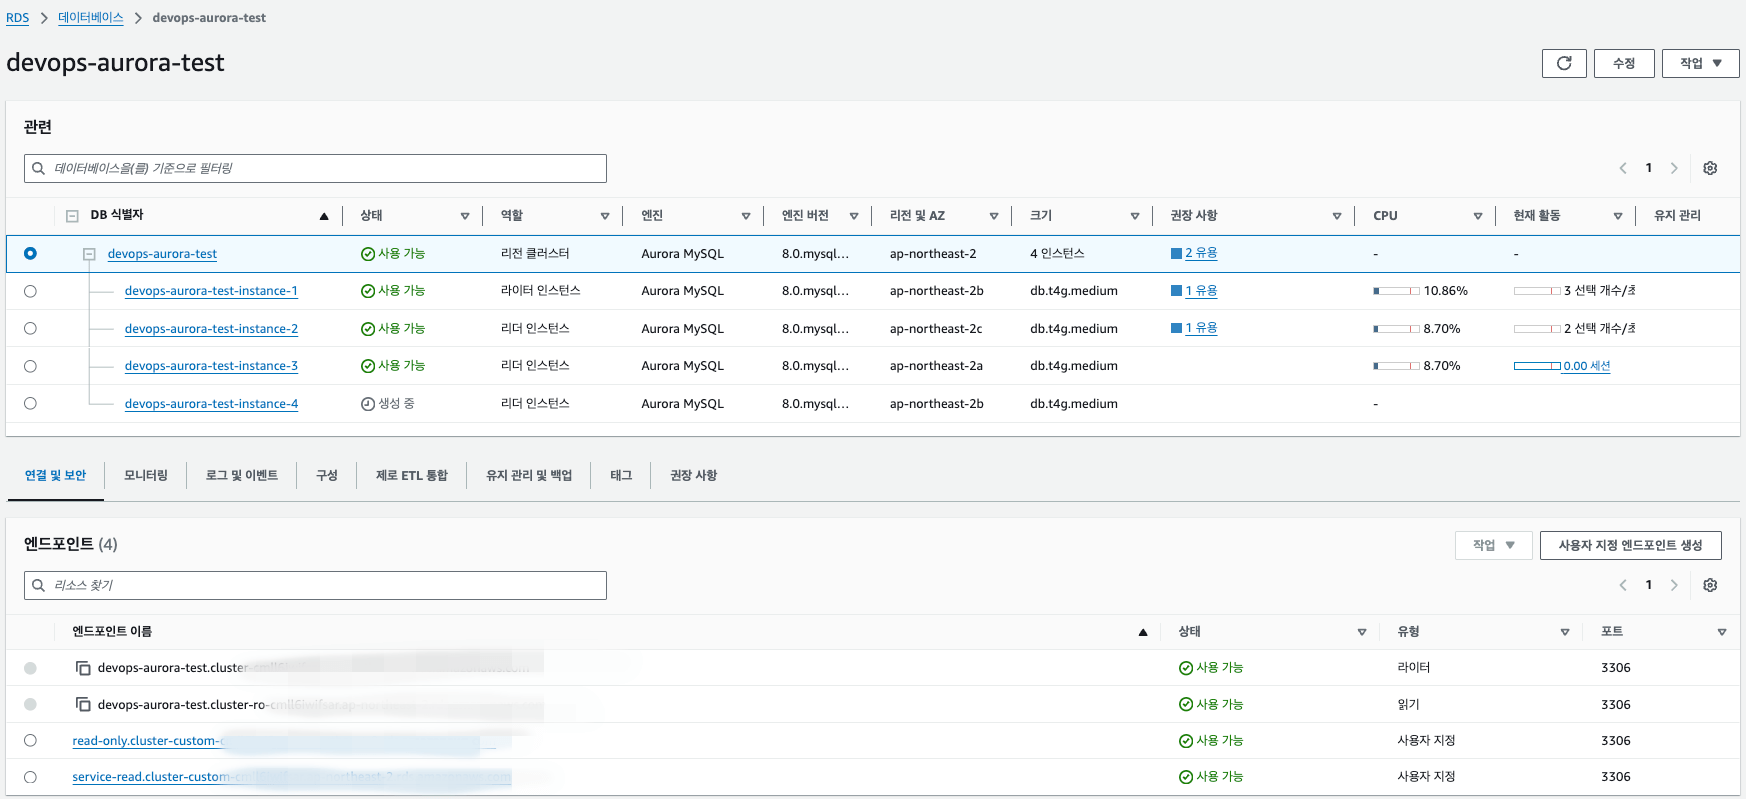
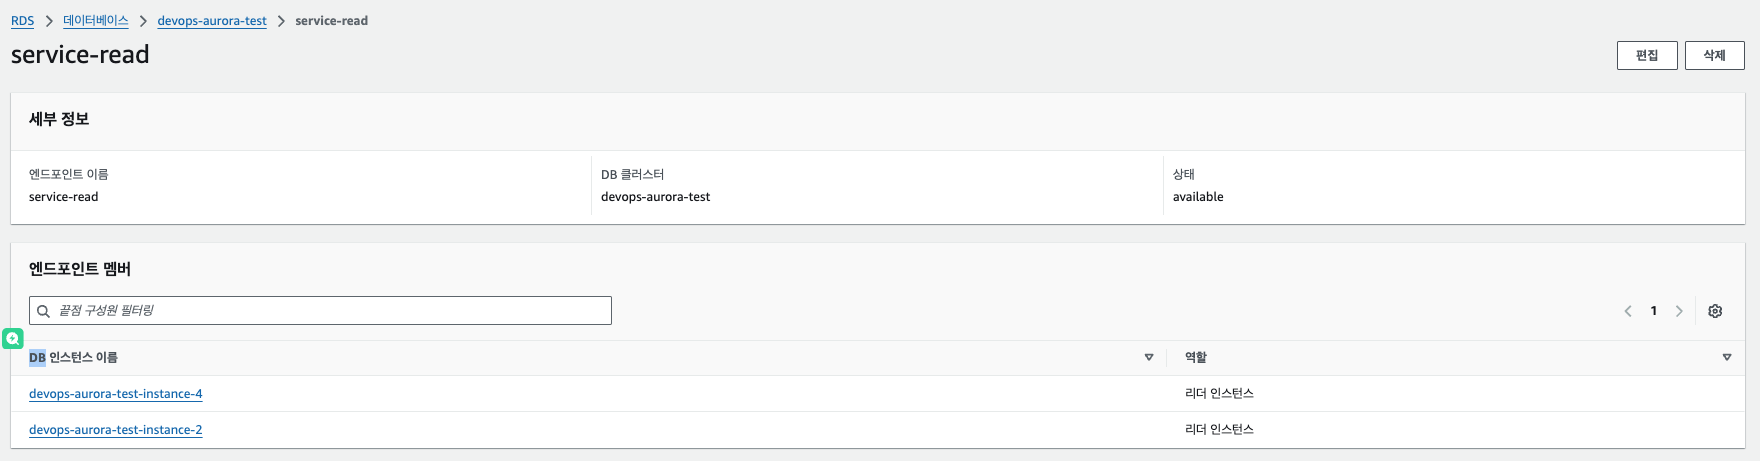
- 다음 화면은 서비스 읽기용 4번 reader를 추가한 뒤, writer를 1번에서 4번으로 바꾸는 페일오버 예제입니다. 페일오버 전에는 서비스 읽기 대상이 2·4번이고, 이후에는 1·2번이 되는지 확인합니다. 페일오버는 실행 중 연결과 업무에 영향을 주므로 검증 환경에서 동작과 복구 절차를 확인한 뒤 운영 계획에 반영합니다.
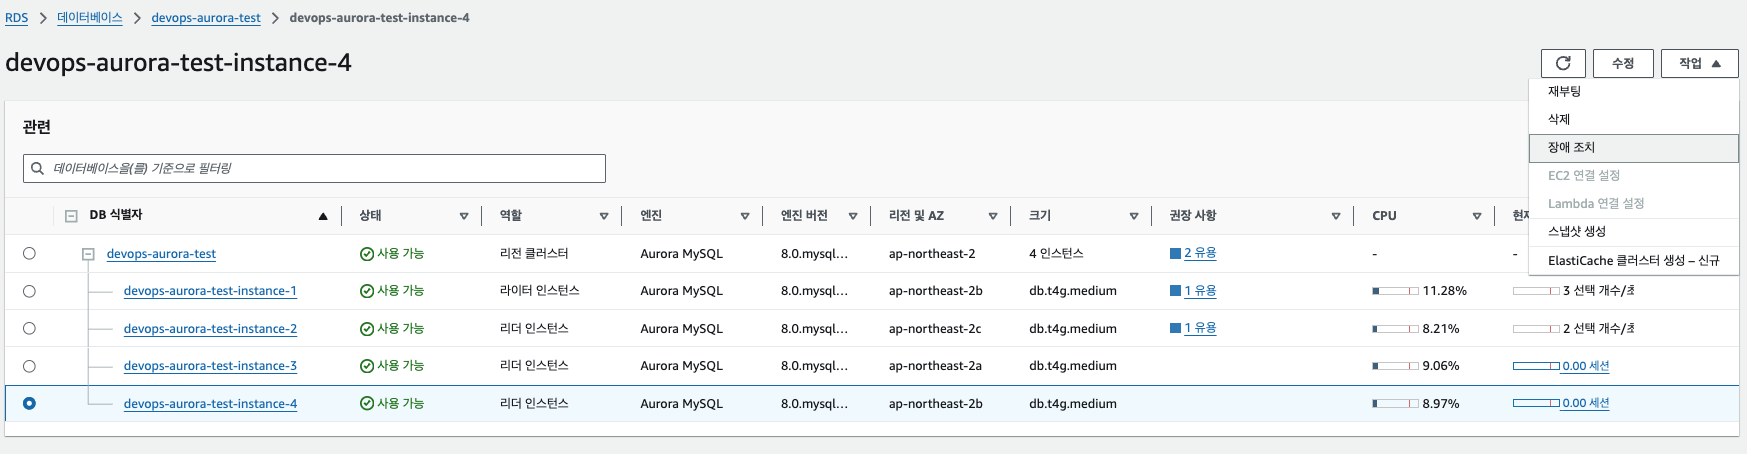
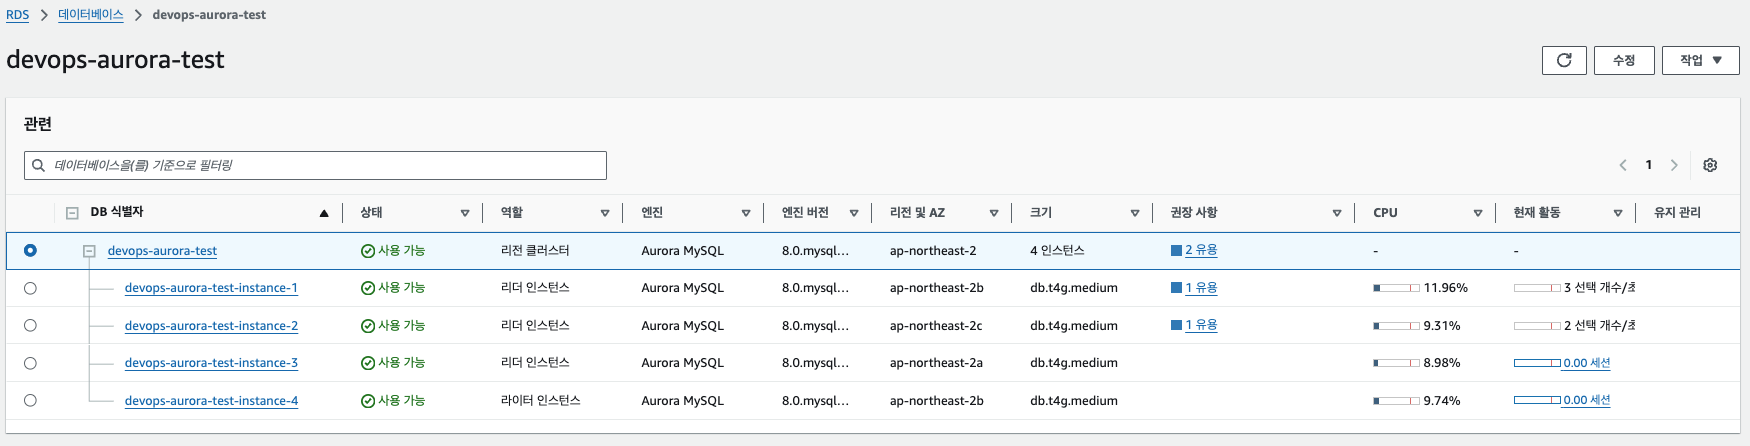
- 4번이 writer로 승격되면
READER대상에서 빠지고, reader로 복귀한 1번이 연결 대상이 되는지 확인합니다. 콘솔 표시뿐 아니라 새 DB 연결에서 접속 인스턴스도 확인합니다.
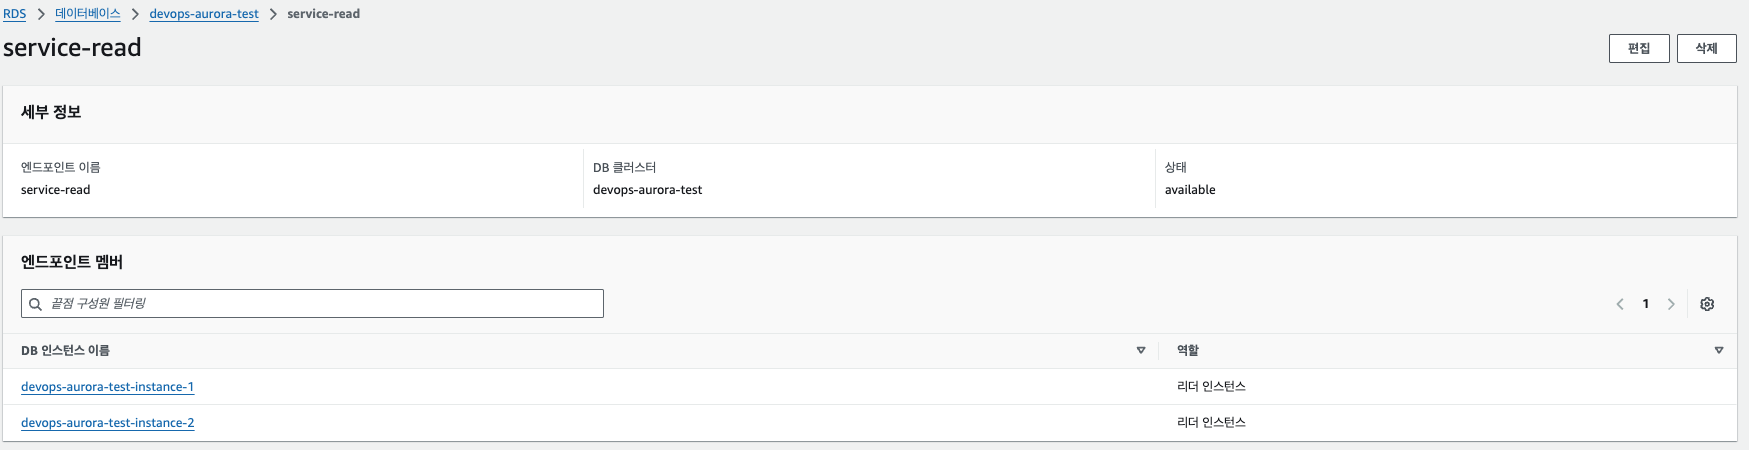
- 분석용 3번의 장애조치 우선순위를 낮춥니다.
promotion-tier는 0이 가장 높고 15가 가장 낮습니다. 15는 승격 금지가 아닙니다. 다른 후보의 상태에 따라 3번이 writer가 될 수 있으며, 그때는 분석용READER엔드포인트의 연결 대상에서 빠집니다.6
aws rds modify-db-instance \
  --region ap-northeast-2 \
  --db-instance-identifier devops-aurora-test-instance-3 \
  --promotion-tier 15
역할과 승격 우선순위는 다음과 같이 대조합니다. 우선순위 변경 자체가 페일오버를 실행하는 것은 아닙니다.63
aws rds describe-db-clusters \
  --region ap-northeast-2 \
  --db-cluster-identifier devops-aurora-test \
  --query "DBClusters[0].DBClusterMembers[].{Instance:DBInstanceIdentifier,Writer:IsClusterWriter,Tier:PromotionTier}" \
  --output table
IMPORTANT —
ANY를 그대로 유지하면 writer·reader 역할 변경에 맞춘 자동 멤버 조정을 기대할 수 없습니다. 이 글의 읽기 분리 구성은READER전환, 멤버 목록 확인, 새 연결 확인까지 완료해야 합니다.
AWS CLI를 이용한 생성 방법
내부용(배치용) 엔드포인트 생성
aws rds create-db-cluster-endpoint \
  --region ap-northeast-2 \
  --db-cluster-identifier devops-aurora-test \
  --db-cluster-endpoint-identifier read-only \
  --endpoint-type READER \
  --static-members devops-aurora-test-instance-3
서비스 읽기용 엔드포인트 생성
aws rds create-db-cluster-endpoint \
  --region ap-northeast-2 \
  --db-cluster-identifier devops-aurora-test \
  --db-cluster-endpoint-identifier service-read \
  --endpoint-type READER \
  --excluded-members devops-aurora-test-instance-3
콘솔 생성과 CLI 생성은 같은 엔드포인트를 만드는 두 가지 경로입니다. 콘솔에서 이미 만들었다면 위 create 명령을 다시 실행하지 않습니다. CLI로 새로 만들 때는 처음부터 --endpoint-type READER를 지정하고, 앞의 조회 명령으로 생성 완료와 실제 타입을 확인합니다. writer 연결에는 기존 클러스터 엔드포인트를 사용합니다.3
--static-members와 --excluded-members는 함께 쓰지 않습니다. 제외 목록을 쓰면 목록에 없는 인스턴스 중 엔드포인트 타입에 맞고 사용 가능한 대상에 연결합니다. 이 글의 READER 타입에서는 writer가 제외됩니다. 만든 뒤 멤버를 손볼 때는 aws rds modify-db-cluster-endpoint, 목록을 확인할 때는 aws rds describe-db-cluster-endpoints를 씁니다.
2.3. 애플리케이션 설정
연결 풀 설정 예시
최소 연결 수: 10
최대 연결 수: 100
연결 타임아웃: 30초
유휴 연결 제거: 300초
이 숫자는 출발점입니다. 최대 연결 수는 엔드포인트에 묶인 인스턴스의 max_connections와 애플리케이션 인스턴스 대수를 함께 계산해서 정합니다.
예를 들어 애플리케이션 8개가 각각 최대 100개 연결을 가지면 전체 상한은 800개입니다. 정상 상태에서 reader가 두 개라고 해서 항상 400개씩 배정된다고 가정하면 안 됩니다. 장애로 한 개만 남았을 때의 여유와 운영·모니터링 연결도 고려합니다.
새 연결과 연결 풀 재사용을 나눠 검증합니다
DNS 기반 분산은 새 연결의 대상을 고르는 과정입니다. 연결 풀에서 이미 열린 연결을 재사용하면 쿼리마다 다른 인스턴스로 이동하지 않습니다. 멤버를 추가해도 기존 풀의 연결이 자동으로 새 인스턴스로 옮겨 가지 않고, 멤버를 제거해도 기존 연결은 유지될 수 있습니다.2
Aurora MySQL에서는 접속한 연결에서 다음을 확인합니다.3
SELECT @@aurora_server_id AS instance_id,
       CONNECTION_ID() AS connection_id;
- 커스텀 엔드포인트로 새 연결을 여러 번 만들고
instance_id를 기록합니다. - 위의 역할 조회 결과와 비교해 서비스 그룹에는 허용한 reader만 나타나는지 확인합니다.
- 같은 풀 연결을 재사용할 때와 연결을 닫고 새로 만들 때를 구분합니다. 짧은 표본이 균등하지 않다는 이유만으로 오류라고 판단하지 않습니다.
- 멤버 변경·페일오버 이후에는 기존 연결의 상태와 새 연결의 대상을 따로 확인합니다. 애플리케이션과 드라이버의 DNS 캐시·연결 수명·재연결 정책도 함께 점검합니다.
Status=available만으로 애플리케이션의 DNS·TLS·인증·접속 대상까지 검증된 것은 아닙니다. 반대로 연결 하나가 실패했다고 모든 연결을 한꺼번에 폐기하면 재접속 부하가 커질 수 있으므로, 풀의 오류 처리와 재시도 정책을 실제 장애 시나리오에서 확인합니다.
분석 세션의 쿼리 타임아웃
분석용 세션은 배치나 리포트 쿼리가 중간에 끊기지 않도록 타임아웃을 길게 잡습니다. 변수 이름과 단위는 엔진마다 다릅니다.
-- Aurora MySQL: 밀리초 단위이고, 읽기 전용 SELECT 에만 적용됩니다
SET SESSION max_execution_time = 3600000;
-- Aurora PostgreSQL
SET statement_timeout = '3600s';
2.4. 단일 멤버 그룹의 가용성
이 예제의 분석용 read-only는 3번 하나만 정적으로 지정합니다. 성능 분리를 보여 주는 구성이지 분석 조회의 고가용성까지 보장하는 구성은 아닙니다.
| 상황 | 새 연결에서 확인할 점 | 운영 대응 |
|---|---|---|
| 3번이 정상 reader | 분석 그룹의 유일한 연결 대상 | 평상시 연결·쿼리 상태를 기록합니다. |
| 3번이 재부팅·비정상 상태 | 그룹에 사용 가능한 다른 reader가 없음 | 작업을 중단·재시도할지, 사전에 정한 대체 경로를 쓸지 결정합니다. |
| 3번이 writer로 승격 | READER 대상에서 제외됨 |
낮은 승격 우선순위만으로 막을 수 없으므로 별도 대응이 필요합니다. |
| 새 분석용 reader를 추가 | 정적 목록은 자동 확장되지 않음 | 정적 멤버 목록도 함께 수정합니다. |
분석 작업의 가용성이 필요하면 서로 다른 가용 영역에 복수의 분석용 reader를 두고 같은 그룹에 명시적으로 포함하는 방법을 검토합니다. 단, 여러 인스턴스의 동시 장애까지 없애 주는 것은 아니므로 재시도·복구 정책도 필요합니다.62
기본 reader 엔드포인트로 무조건 대체하면 분석 쿼리가 서비스용 reader로 갈 수 있고, reader가 전혀 없으면 writer로 연결될 수 있습니다. 원래의 워크로드 분리 목적을 유지할지, 장애 시에는 조회를 중단할지 먼저 정합니다.1
3. 커스텀 엔드포인트 활용의 장점
3.1. 성능 최적화
워크로드 분리
- 장시간 실행 쿼리와 빠른 응답 쿼리의 분리
- 리소스 경합 최소화
- 쿼리 타임아웃 설정의 유연성
버퍼 풀 분리
인스턴스마다 버퍼 풀이 따로 있으므로, 분석용 인스턴스의 대용량 스캔이 서비스 인스턴스의 캐시를 밀어내지 않습니다.
이 분리는 주로 인스턴스의 CPU·메모리·캐시 경합을 줄이는 방법입니다. 클러스터 데이터와 스토리지는 공유하므로, 완전히 독립된 클러스터 수준의 성능·장애 격리를 의미하지는 않습니다.6
3.2. 운영 효율성
모니터링 및 관리
- 워크로드별 독립적인 모니터링
- 리소스 사용량 추적 용이
- 장애 원인 신속 파악
확장성
- 워크로드 그룹별 인스턴스 사양·멤버 수 조정
- 인스턴스가 늘거나 줄어도 애플리케이션의 접속 정보는 그대로 유지
- 트래픽 피크 대응
Aurora Auto Scaling의 범위
기본 Aurora Auto Scaling은 커스텀 엔드포인트별 인스턴스 수를 따로 관리하는 기능이 아닙니다. reader CPU·연결 수를 사용하는 사전 정의 지표는 클러스터의 모든 reader 평균을 기준으로 하며, 수동으로 만든 reader와 커스텀 엔드포인트 소속 reader도 포함합니다.7
따라서 분석용 3번의 CPU 상승이 클러스터 평균을 올리고, 그 결과 새 reader가 추가될 수 있습니다. 이 글의 서비스 그룹은 3번만 제외하므로 새 reader가 서비스 그룹에 들어가지만, 정적 목록인 분석 그룹에는 자동으로 들어가지 않습니다. 분석 부하로 증설했는데 분석 그룹의 용량은 그대로인 상황을 검토해야 합니다.
그룹별로 용량을 따로 늘려야 한다면 인스턴스 생성·멤버 목록 변경을 함께 관리하는 운영 절차나 별도 자동화가 필요합니다. Auto Scaling 정책을 만들었다는 사실만으로 그룹별 독립 확장이 완성되지는 않습니다.
3.3. 비용 최적화
- 별도의 프록시 계층을 두지 않으므로 그 계층의 요금과 운영 부담이 없습니다.
- 워크로드에 맞는 인스턴스 클래스를 그룹별로 따로 고를 수 있습니다.
3.4. 보안
커스텀 엔드포인트는 보안 경계가 아닙니다. Aurora의 보안 그룹 변경은 같은 클러스터의 모든 DB 인스턴스에 적용됩니다. 같은 클러스터의 분석용 인스턴스와 서비스용 인스턴스에 서로 다른 보안 그룹 경계를 둔 것처럼 설명하면 안 됩니다.8
워크로드별 계정·DB 권한을 별도로 정하고, 읽기 애플리케이션에는 필요한 조회 권한만 부여합니다. read-only라는 DNS 이름이나 READER 라우팅 타입이 DB 계정의 쓰기 권한을 제거하는 것은 아닙니다. 페일오버 전부터 열려 있던 연결도 고려해야 합니다.
IAM 데이터베이스 인증을 사용하더라도 네트워크 접근, 접속 인증, DB 안에서 실행할 수 있는 SQL 권한은 각각 확인합니다. 네트워크 수준의 분리가 요구된다면 커스텀 엔드포인트만으로 충족했다고 보지 말고 클러스터·네트워크 설계까지 검토합니다.8
4. 운영 및 모니터링
4.1. 핵심 모니터링 지표
- CPU 사용률
- 메모리 사용량
- IOPS
- 지연 시간
- 쓰레드 수
- 연결 수
4.2. 알림 임계값 예시
아래 값은 출발점입니다. 인스턴스 클래스와 쿼리 특성에 맞춰 조정합니다. 특히 분석용 인스턴스는 CPU가 오래 높게 유지되는 것이 정상이므로, 서비스 인스턴스와 같은 기준을 쓰면 알림이 계속 울립니다.
성능 관련
- CPU 사용률 > 80%
- 가용 메모리 < 20%
- 평균 지연 시간 > 100ms

연결 관련
- 활성 연결 수 > 설정된 임계값
- 연결 거부 발생
- 연결 타임아웃 발생
WARNING — 커스텀 엔드포인트는 스냅샷에 포함되지 않습니다. 스냅샷으로 클러스터를 복원하면 엔드포인트를 다시 만들어야 하고, 원본과 같은 리전에 복원했다면 이름도 새로 지어야 합니다. 복원 절차를 문서로 남길 때 이 단계를 함께 적어 두는 편이 좋습니다.
4.3. 변경·장애 시 검증할 항목
| 시나리오 | 확인할 내용 |
|---|---|
| 콘솔 생성 후 READER 전환 | CustomEndpointType=READER, 변경 완료 상태, 새 연결의 인스턴스 |
| 서비스 reader가 writer로 승격 | 새 연결 대상에서 제외되는지, 기존 연결·실행 중 쿼리가 어떻게 종료·복구되는지 |
| 유일한 분석 reader의 재부팅 | 분석 작업의 타임아웃·재시도·중단 정책이 동작하는지 |
| reader 추가 또는 Auto Scaling | 서비스 제외 목록과 분석 정적 목록에 예상대로 반영되는지 |
| 그룹에서 인스턴스 제거 | 새 연결의 대상과 기존 풀 연결의 잔류를 구분했는지 |
| 스냅샷 복원 | 엔드포인트 재생성, 새 DNS 주소 적용, 계정·TLS·그룹별 접속 확인 |
CPU·연결 수·쿼리 지연은 실제 연결된 DB 인스턴스와 애플리케이션 풀 단위로 대조합니다. 커스텀 엔드포인트 하나의 상태만 보고 그룹 전체가 정상이라고 판단하지 않습니다.
5. 결론 및 베스트 프랙티스
AWS Aurora의 커스텀 엔드포인트를 활용하면 별도 SQL Proxy 없이 내부 조회용 인스턴스와 서비스 읽기 인스턴스 그룹을 나눌 수 있습니다. 분석과 서비스 조회의 인스턴스 자원 경합을 줄이되, 역할 변경·기존 연결·단일 멤버 장애·공유 클러스터의 제약까지 함께 설계해야 합니다.
5.1. 설계 원칙
- 워크로드 특성에 따른 명확한 분리
- 한 엔드포인트 안의 인스턴스는 사양과 파라미터를 맞춰 구성
- 앞으로 추가될 인스턴스를 어느 엔드포인트가 받을지 정적 목록과 제외 목록으로 미리 결정
- 페일오버로 역할이 바뀔 때의 멤버십 동작을 엔드포인트 타입으로 결정
- 승격 우선순위를 승격 금지로, 연결 대상 분리를 보안 격리로 해석하지 않기
- Auto Scaling 지표와 새 reader의 그룹 편입 규칙을 함께 확인
5.2. 운영 체크리스트
- 정기적인 성능 모니터링
- 보안 설정 검토
- 비용 최적화 리뷰
- 장애 대응 시나리오 검증
- 스냅샷 복원 절차에 엔드포인트 재생성 포함
- 변경 완료 상태뿐 아니라 새 연결의 실제 접속 인스턴스 확인
- 단일 멤버 장애와 기존 연결 풀의 잔류에 대한 대응 확인
참고 자료
-
Amazon Aurora User Guide — Reader endpoints for Amazon Aurora. reader가 없을 때의 writer 연결. https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Aurora.Endpoints.Reader.html ↩ ↩2
-
Amazon Aurora User Guide — Membership rules for custom endpoints. ANY·READER, 정적·제외 목록, 기존 연결과 역할 변경. https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Aurora.Endpoints.Custom.Considerations.html ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Amazon Aurora User Guide — Using custom endpoints. 구성 예제, 승격 우선순위, 접속 인스턴스 확인. https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Aurora.Endpoint.Tutorial.html ↩ ↩2 ↩3 ↩4
-
AWS CLI Reference — modify-db-cluster-endpoint. 엔드포인트 타입과 멤버 설정 변경. https://docs.aws.amazon.com/cli/latest/reference/rds/modify-db-cluster-endpoint.html ↩
-
AWS CLI Reference — describe-db-cluster-endpoints. 상태·CustomEndpointType·설정 목록 조회. https://docs.aws.amazon.com/cli/latest/reference/rds/describe-db-cluster-endpoints.html ↩
-
Amazon Aurora User Guide — High availability for Amazon Aurora. 승격 우선순위와 공유 스토리지 구조. https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Concepts.AuroraHighAvailability.html ↩ ↩2 ↩3 ↩4
-
Amazon Aurora User Guide — Amazon Aurora Auto Scaling with Aurora Replicas. reader 평균 지표와 조정 범위. https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Aurora.Integrating.AutoScaling.html ↩
-
Amazon Aurora User Guide — Controlling access with security groups. 클러스터 내 모든 인스턴스에 적용되는 보안 그룹. https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Overview.RDSSecurityGroups.html ↩ ↩2