Graph DB? 그래프 데이터베이스
오랜만에 글을 쓰는 것 같네요. 현재 이런저런 일도 많이 있고 방송대 전공 과목의 과제와 기말시험을 대비한 공부를 하느라 포스팅이 소홀했습니다. 기말 공부를 하던 중에 머리도 식힐 겸 Graph DB를 조금 알아보았습니다.
NoSQL을 쓰는 곳이 늘고 NoSQL 경험자를 찾는 기업도 많지만, NoSQL로 묶이는 데이터베이스들은 각각 자기만의 아키텍처를 가집니다. MongoDB를 조금 다뤄 봤다고 해서 Neo4j나 ArangoDB 같은 그래프 데이터베이스를 바로 다룰 수 있는 것은 아니어서, 역시 따로 공부가 필요하더군요.
일반적으로 GraphDB라고 했을 때 어떤 생각이 떠오르시나요?
그래프는 일반적으로 통계를 나타낼 때 사용하는 막대 그래프 같은 통계나 수치를 보여주는 것이 가장 먼저 떠오르지 않을까 싶네요. 또는 IT업계 분들이라면, 뭐 그래픽 카드의 성능을 이용하는가 라고 생각할 수도 있을 것 같습니다.
GraphDB는 이런 것들과 전혀 관계 없으며, 그래프는 꽤 오래된 개념으로 스위스의 수학자 레온하르트 오일러의 학술 논문에서 처음 기술되었습니다. 그는 쾨니히스베르크의 7개의 다리로 알려진 문제를 풀고 있었고, 이 문제는 요즘에는 수학을 공부하는 학생이라면 한번쯤 본 적이 있을 겁니다.
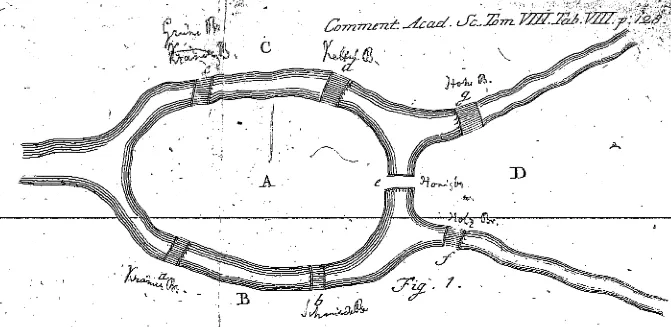
쾨니히스베르크의 7개의 다리
- 7개의 다리가 도시의 서로 다른 4개 지역을 잇고 있음
- 각 다리를 한 번씩만 건너서 7개 다리를 모두 건너는 경로를 찾는 것
오일러는 경로를 하나하나 따라가 보는 대신, 각 지역에 연결된 다리의 개수를 세는 쪽으로 문제를 바꿨습니다. 그렇게 해서 그런 경로가 존재하려면 다리 개수가 홀수인 지역이 없거나 정확히 둘이어야 한다는 조건을 얻었습니다. 쾨니히스베르크에서는 네 지역 모두 다리 개수가 홀수여서, 조건을 만족하는 산책은 불가능하다는 결론이 나옵니다. 이 과정에서 나온 것이 바로 그래프이며, 그래프 이론의 시발점이 되는 것이죠.

이렇게 탄생한 그래프를 정의한다면, “연결되어 있거나 서로 관련이 있는 2개 이상의 실체를 추상화하여 수학적으로 표현한 것”입니다.
수학에서는 위 그림에서 빨간 원으로 표시된 부분을 정점(Vertex)이라고 하지만, GraphDB에서는 노드라고 표현합니다.
정점을 잇는 선들을 Edge라고 표현하며, GraphDB에서는 엣지를 통해 각각의 노드들이 서로 연결되어 있는 구조를 통해 그래프가 생성됩니다.
이처럼 오일러의 모델과 알고리즘을 이용하여, 그래프를 사용해 모델링과 솔루션 패턴을 연구하는 과학 분야를 그래프 이론이라고 부릅니다. 그리고 그래프의 유형에는 여러 가지가 있습니다.
제품 현황
대표적인 그래프 데이터베이스는 Neo4j입니다. 2026년 9월 기준으로 Neo4j는 버전 체계가 캘린더 버저닝으로 바뀌어 태그 2026.08.1이 확인되고, Community 에디션은 GPL v3입니다. 버전을 확인하는 경로에는 함정이 하나 있습니다. Neo4j의 GitHub Releases는 2017년 항목에서 멈춰 있어서, 릴리스 목록을 근거로 쓰면 9년 전 알파 버전을 현재 버전으로 적게 됩니다. 실제 버전은 태그 쪽에 있습니다.
Neo4j 말고도 ArangoDB, OrientDB 같은 선택지가 있습니다. 다만 2021년 이후 라이선스 지형이 바뀌었습니다. ArangoDB Self Managed는 2024년 3월 릴리스부터 Business Source License 1.1 적용 대상이고, 저장소의 라이선스 파일에 Change Date가 릴리스 4주년, Change License가 Apache License 2.0으로 적혀 있습니다. Additional Use Grant는 내부 운영 용도를 허용하되, 제3자가 자기 데이터로 데이터베이스를 만들고 관리하게 해 주는 상업적 서비스로 제공하는 것은 제외합니다. 그래서 지금은 ArangoDB를 Apache 2.0 오픈소스 제품으로 소개할 수 없습니다. OrientDB는 3.2.56(2026-09-02)으로 릴리스가 이어지고 있습니다.
GraphDB들은 NoSQL의 범주에 들어 있지만, 일반적인 NoSQL의 데이터베이스들과는 다른 특징을 보여주는데 바로 모든 작업을 그래프와 그래프 이론을 통해 동작한다는 것입니다.
GraphDB의 특징
그래프로 데이터를 탐색할 때 얻는 가장 큰 이점은, 연결된 노드로 넘어갈 때 전역 인덱스를 다시 조회하지 않는다는 것입니다. 노드가 자기에게 붙은 관계를 직접 가리키고 있어서 거기서 이웃 노드로 바로 이동합니다. 이 성질을 index free adjacency라고 합니다. 덕분에 관계를 따라가는 탐색에 맞고, 관계형 데이터베이스보다 관계를 직관적으로 표현할 수 있으며 모델에 관계를 그대로 남길 수 있습니다.
관계형 데이터베이스에서 여러 홉을 거치는 탐색은 홉마다 조인을 하나씩 더 쌓는 형태가 됩니다. 그러면 테이블 크기, 데이터 분포, 조인 순서, 중간 결과 크기를 함께 봐야 하는 문제로 바뀝니다. 그래프 데이터베이스는 같은 탐색을 관계를 따라가는 연산으로 표현합니다. 다만 어느 쪽이 몇 배 빠른지는 스키마와 데이터 분포에 따라 갈리고, 조건을 공개한 비교 측정 자료가 드물기 때문에 배수로 말할 수는 없습니다.
스키마를 미리 고정하지 않아도 되고, 반정규화된 데이터를 담기에 맞습니다. 노드는 RDBMS의 행에 가깝습니다. 행이 칼럼마다 값을 갖는 것처럼, 노드도 키와 값으로 된 속성을 갖습니다.
GraphDB에서 관계는 항상 시작점과 끝점이 있는 방향을 가집니다. 자체 참조가 가능해서 시작과 끝이 같은 노드가 될 수도 있습니다. 관계는 명시적이며, 노드처럼 속성을 가질 수도 있습니다.
질의 언어
2021년에는 그래프 데이터베이스마다 질의 언어가 갈려 있었고 공통 표준이 없었습니다. 지금은 표준이 생겼습니다. GQL이 ISO/IEC 39075:2024로 2024년 4월에 발행됐습니다. GQL 표준 프로젝트 사이트가 발행을 공지하고 있고, Neo4j 문서도 GQL을 “the new ISO International Standard query language for graph databases”로 소개하면서 기능의 근거로 같은 표준 번호를 적습니다.
| 언어 | 현재 위치 |
|---|---|
| GQL | ISO/IEC 39075:2024 로 발행된 국제 표준 |
| Cypher | Neo4j의 질의 언어. GQL이 MATCH·RETURN 형태를 여기서 가져갔습니다 |
| Gremlin | Apache TinkerPop의 순회 언어. 3.8.2(2026-09-01) |
| SPARQL | RDF 질의 언어. 1.1 Query가 W3C 권고안이고 1.2는 초안 단계 |
Neo4j는 Cypher가 GQL의 필수 기능 대부분을 지원하고 일부 필수 기능은 아직 구현 중이라고 문서에 적습니다. Cypher를 쓰고 있었다면 GQL 문법과의 차이가 크지 않다는 뜻이지만, Cypher를 쓰는 것이 곧 표준을 쓰는 것이라고 말할 단계는 아닙니다.
SPARQL은 이름이 나란히 나오지만 대상이 다릅니다. SPARQL은 RDF를 질의하는 언어이고, Cypher·GQL·Gremlin이 다루는 것은 속성 그래프(property graph)입니다. 그래프라는 말이 같아도 데이터 모델이 다르므로 선택지를 같은 줄에 놓고 비교하면 안 됩니다.
GraphDB를 어디다 사용해야 할까?
여러 테이블을 거쳐 관계를 따라가는 질의가 요구의 중심이라면 GraphDB가 좋은 대안이 됩니다. 인덱스로 시작 노드를 찾고, 거기서부터는 index free adjacency로 그 노드에 붙은 관계만 따라갑니다. 패턴이 맞지 않는 쪽은 더 내려가지 않습니다. 그래서 탐색 비용은 그래프 전체 크기보다 지나간 노드에 붙은 관계 수에 좌우됩니다. 전체 데이터가 늘어도 비용이 그대로라는 뜻은 아닙니다. 지나가는 노드의 연결 수가 같이 늘면 비용도 늘어납니다.
비즈니스 인텔리전스 시스템에서도 강점을 가지고 있습니다. 관계형 기반 분석에서는 데이터를 따로 복제하고 반정규화한 집계 구조를 미리 만들어 두는 경우가 많습니다. GraphDB는 관계를 그대로 두고 질의로 따라갈 수 있어서 사본을 덜 만들어도 됩니다.
서로 다른 데이터들이 어떻게 연관되어 있는지 확인하는 경우에도 GraphDB는 강점을 보입니다. 시작과 끝이 되는 노드만 알려주고 그래프 이론을 적용하기만 하면 되기 때문이죠.
GraphDB를 사용하지 말아야 하는 경우
모든 데이터베이스들이 그렇듯, 강점이 있으면 약점도 있습니다. GraphDB에서 피해야 하는 작업은 대규모 집합지향 쿼리, 글로벌 그래프 작업, 간단한 집계 중심 질의입니다.
여러 항목을 확인하는 데 조인과 집계 연산이 많이 필요하지 않고 단순히 데이터를 취합하는 용도라면, 관계형 데이터베이스보다 나은 성능을 제공한다고 할 수 없습니다.
GraphDB는 로컬 그래프를 처리하는 데는 뛰어나지만, 그래프 전체를 보는 작업에는 자원과 시간을 많이 씁니다. 노드 클러스터를 찾고, 노드 사이의 알려지지 않은 관계 패턴을 발견하고, 그래프 구성요소의 중심과 구역 사이를 정의하는 작업이 여기 해당합니다.
앞서 말했듯이 GraphDB는 복잡한 연산에 최적화되어 있습니다. 반대로 복합성이 낮은 단순한 구조의 간단한 질의들은 GraphDB에서 상당히 비효율적으로 처리됩니다.
이렇듯 단점도 있으니, 성능이 잘 나온다는 이야기만 보고 고르기보다 어떤 시스템을 구축하려는지를 먼저 정하는 것이 가장 중요합니다.
GraphDB를 간단히 알아보았고, 정확히 어떻게 동작하고, 어떻게 노드 간 관계가 정의되고 하는지는 Neo4j나 다른 GraphDB의 아키텍처를 더 뜯어 봐야 할 것 같습니다. 지금은 MongoDB에 집중하고 있기도 해서 언제 여유가 되고 기회가 된다면 공부해 보면 재밌을 것 같습니다. 기말 공부가 끝나면 MongoDB에 대한 포스팅을 마저하고, MongoDB DBA 자격시험을 좀 준비해야겠네요.
참고 자료
도서: Neo4j로 시작하는 그래프 데이터베이스 2/e