MongoDB Developer Workshop 후기 (with Google Cloud)
오랜만에 포스팅입니다. 정말 오랜만이네요. 이직하고 나서 딱히 쓸 글이 없었습니다. 다들 저보다 잘하시고, 연차는 쌓여가는데 초급 포스팅만 계속 하기도 좀 그랬습니다.
이번에 MongoDB Korea에서 오프라인 핸즈온 세미나를 열었습니다.
전 세계 게임업계의 MongoDB 레퍼런스를 소개하고, Google Cloud의 BigQuery와 함께 MongoDB로 데이터 분석 파이프라인을 구축하는 법을 알 수 있는 좋은 기회였습니다.
또 MongoDB가 주력하는 관리형 클라우드 MongoDB 서비스인 Atlas의 핸즈온이 아젠다에 포함되어 있었습니다.
세미나 시작
우선 전 세계 게임업계가 MongoDB를 어떻게 사용하고 있는지를 다룬 아젠다로 시작했습니다. 이번 아젠다에서 MongoDB 측이 소개한 게임 회사들은 아래와 같습니다.
- 스퀘어 에닉스
- 텐센트
- Epic Games
- 세가
- EA Sports
- 이름이 기억 안나는 중국 2위의 게임 회사
이런 큰 게임회사들이 MongoDB를 사용하는 이유와 이점을 설명했습니다.
중국의 거대 기업 텐센트는 왜 MongoDB를 사용하는가?
- 유연한 개발 요구사항 충족
- 주변 플레이어 지원 (위치 기반)
- 대량의 데이터 지원 및 무중단 업그레이드
- 운영 데이터 분석 지원
- 개발언어와 접근성 호환성 높음 – Node.js
스퀘어 에닉스의 효율성을 위한 빅데이터 게임 플랫폼 구축
- SQL 서버 비용 감소
- 데이터 처리 능력 0.5TB/day
- 데이터 분석 3weeks → 2min
즉, MongoDB가 강조하는 장점은 “실시간 운영, 실시간 분석에 최적화된 데이터베이스”입니다. 운영과 분석을 동시에 할 수 있다는 점에 초점을 맞춰 소개했습니다.
그리고 MongoDB를 제대로 이해하지 못하고 사용하는 많은 사용자가 겪는 “MongoDB는 성능이 안 좋아요!”에 대한 해명도 해주셨죠.
- 20%의 사용자: MongoDB에 최적화된 모델링 설계를 하지 못함 (RDBMS처럼 설계)
- 80%의 사용자: 인덱스를 제대로 활용하지 못함 (인덱스 설계가 매우 중요)
MongoDB to BigQuery 데이터 분석 파이프 라인
앞서 MongoDB에서 자체적으로 분석할 수 있는데도 BigQuery를 사용해야 하는 이유를 다음과 같이 설명했습니다.
데이터 분석을 하게 되면 더 많은 요구사항과 더 많은 데이터를 다루게 되는데, 점점 커져가는 데이터 분석 환경에 따라 BigQuery 같은 뛰어난 제품이 필요하다는 것이 핵심 메시지였습니다.
BigQuery가 좋은 이유는 구글이 데이터 분석 플랫폼으로 시작한 회사이기 때문에 인프라보다 분석 기술에 집중했으며, 접근이 쉽다는 장점이 있습니다.
최근 데이터 분석 트렌드가 AI, 머신러닝 분야이며, 예전처럼 분석의 최종 지점이 시각화가 아닌 AI와 머신러닝 쪽으로 변해가고 있기 때문에 사용하기 쉬운 BigQuery가 적합하다고 설명했습니다. 도구가 쉬워질수록 분석가의 학습 곡선이 완만해져 접근이 편합니다.
그리고 기존에는 스토리지 비용이 비쌌기 때문에 DW 형태로 저장했지만, 머신러닝에는 원본 데이터를 그대로 저장하는 것이 필요합니다. BigQuery는 DW+Lake를 함께 사용할 수 있는 데이터 저장소이기 때문에 원본 데이터를 바로 저장해 머신러닝에 이용할 수 있다는 점이 특징입니다.
또한 데이터 분석을 위한 포괄적인 BI 솔루션인 ‘구글 데이터 스튜디오’(현재는 Looker Studio)가 무료라는 점도 강조했습니다.
GCP는 BigQuery를 혁신적이고 개방적인 서버리스 제품으로 소개했습니다. 완전 관리형 서비스로 증설이 필요 없고, 연산이 필요한 만큼 리소스를 모두 제공하기 때문에 사양에 얽매이지 않는 것이 서버리스의 장점입니다.
예를 들어 BigQuery에서 1,000억 건, 4.06TB 데이터를 처리하는 데 걸리는 시간은 20~30초 사이이며, 데이터 분석 시스템이 왜 빨라야 하는가에 대한 답변으로 “분석을 하는 사람들은 시간과 싸움을 하고 있으며, 분석이 빨라야 빠른 의사 결정이 이루어지기 때문”이라고 설명했습니다.
다른 DW처럼 Data Mart로 데이터 복제가 필요 없기에 별도의 자원 낭비가 없으며, Standard SQL을 지원합니다.
세미나 당시 소개된 비용 정보는 다음과 같습니다.
- 저장: 1TB / 월 $20
- 장기 저장: 1TB / 월 $10
또한 BigQuery는 데이터를 이전하지 않고 머신러닝에 바로 사용할 수 있습니다.
데이터 분석 파이프라인
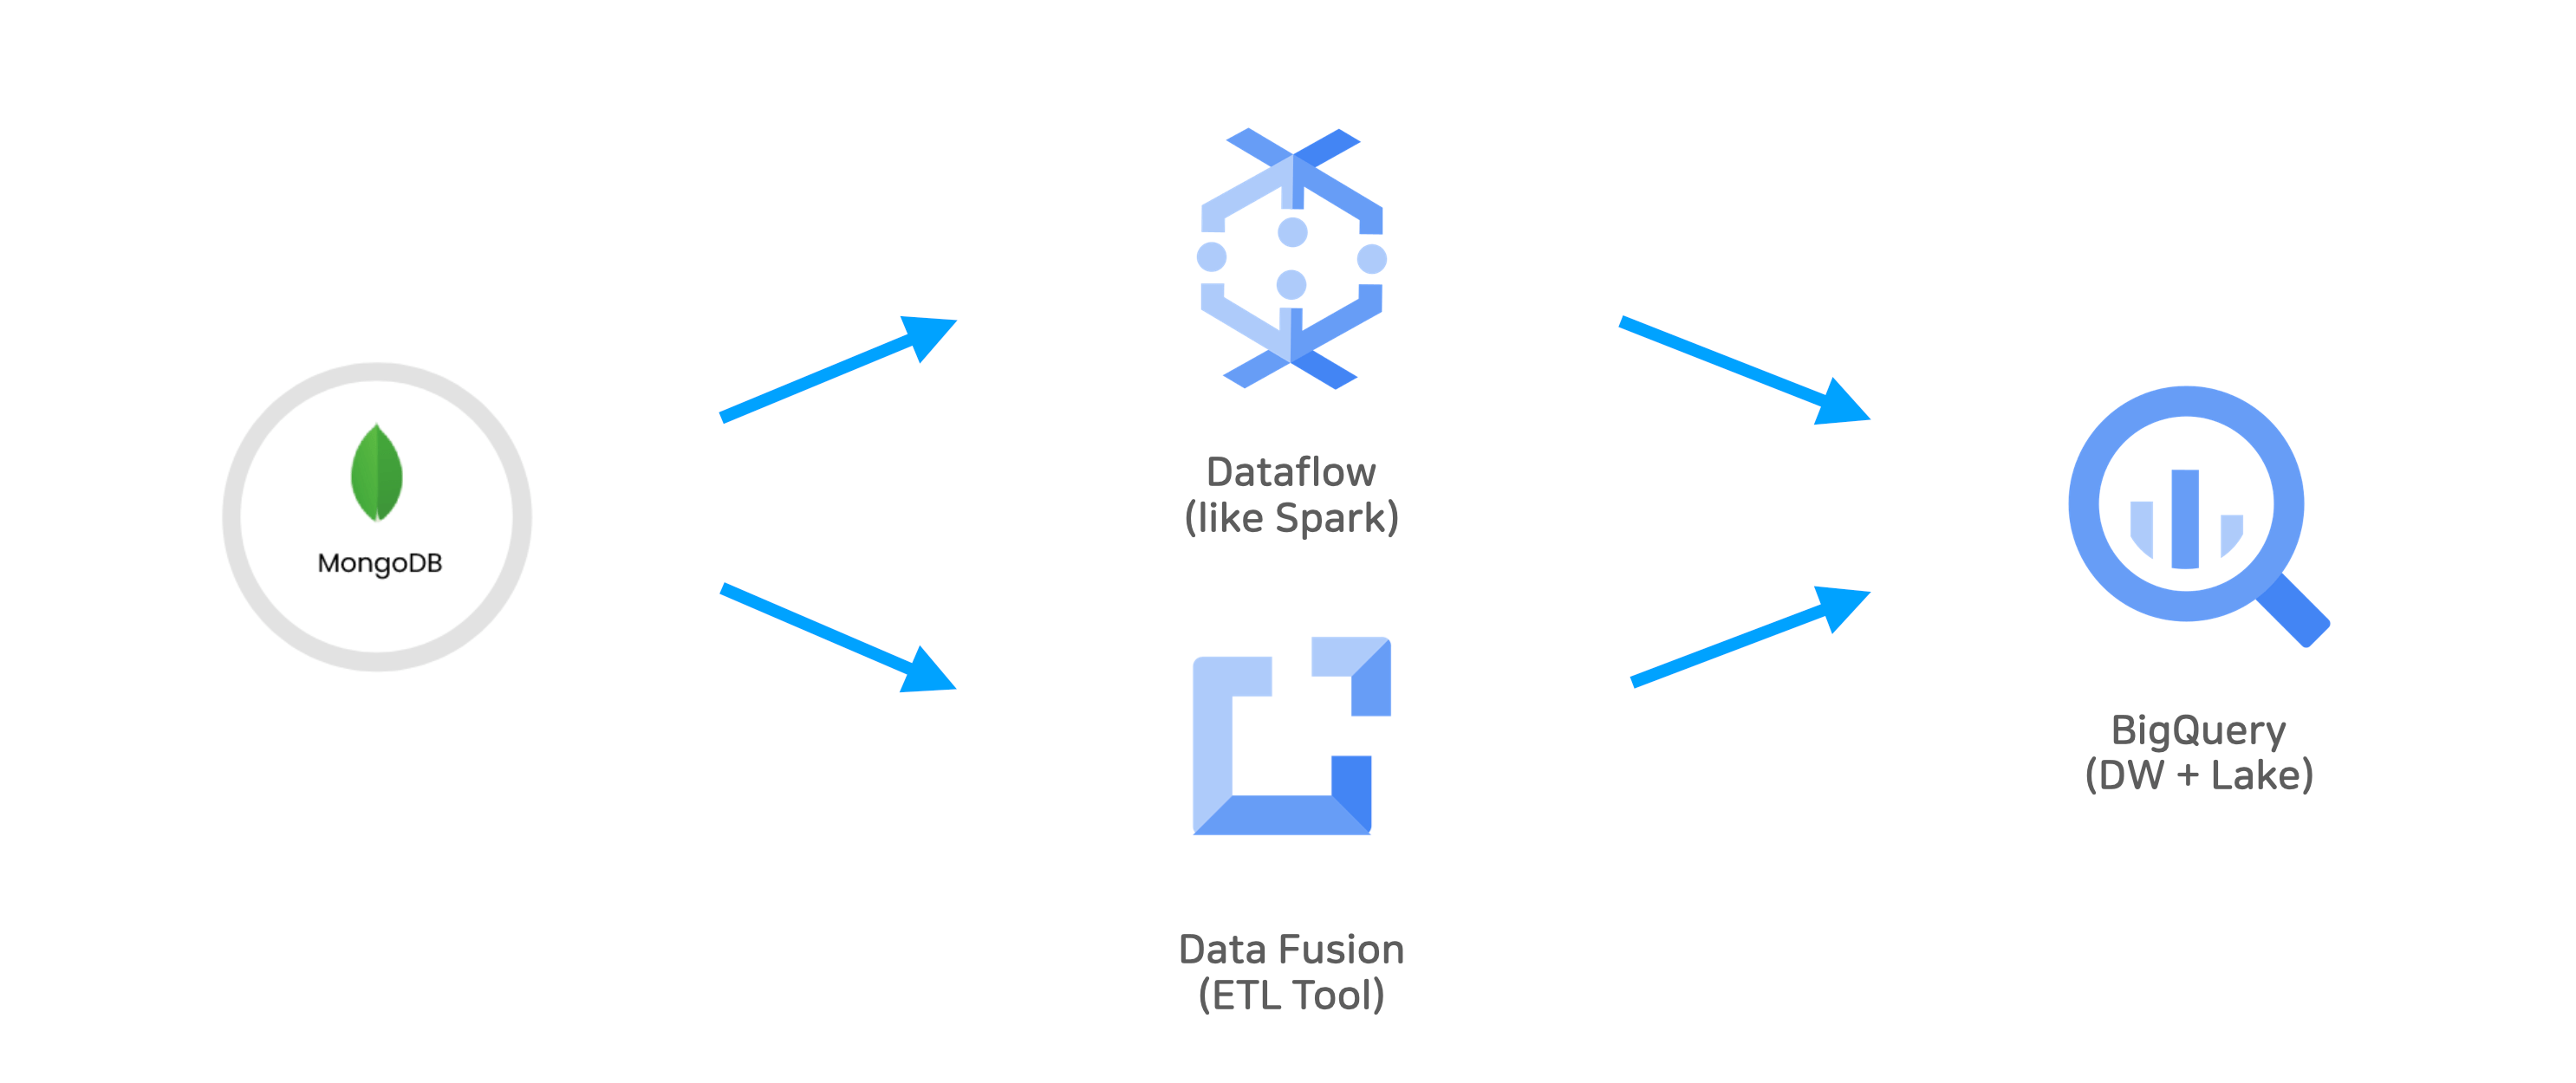
BigQuery에 데이터를 적재하는 방법을 소개했습니다. 초기 데이터를 적재하는 방법으로는 두 가지를 설명해 주셨고, 실시간 데이터 전송 파이프라인도 설명해 주셨습니다.
- 초기 로딩: Mongo → Cloud Dataflow → BigQuery
- 초기 로딩: Mongo → ETL 도구 (Data Fusion) → BigQuery
- 실시간 동기화: Mongo (Change Stream) → Cloud Pub/Sub (like Kafka) → Cloud Dataflow (분산 처리 엔진 like Spark) → BigQuery
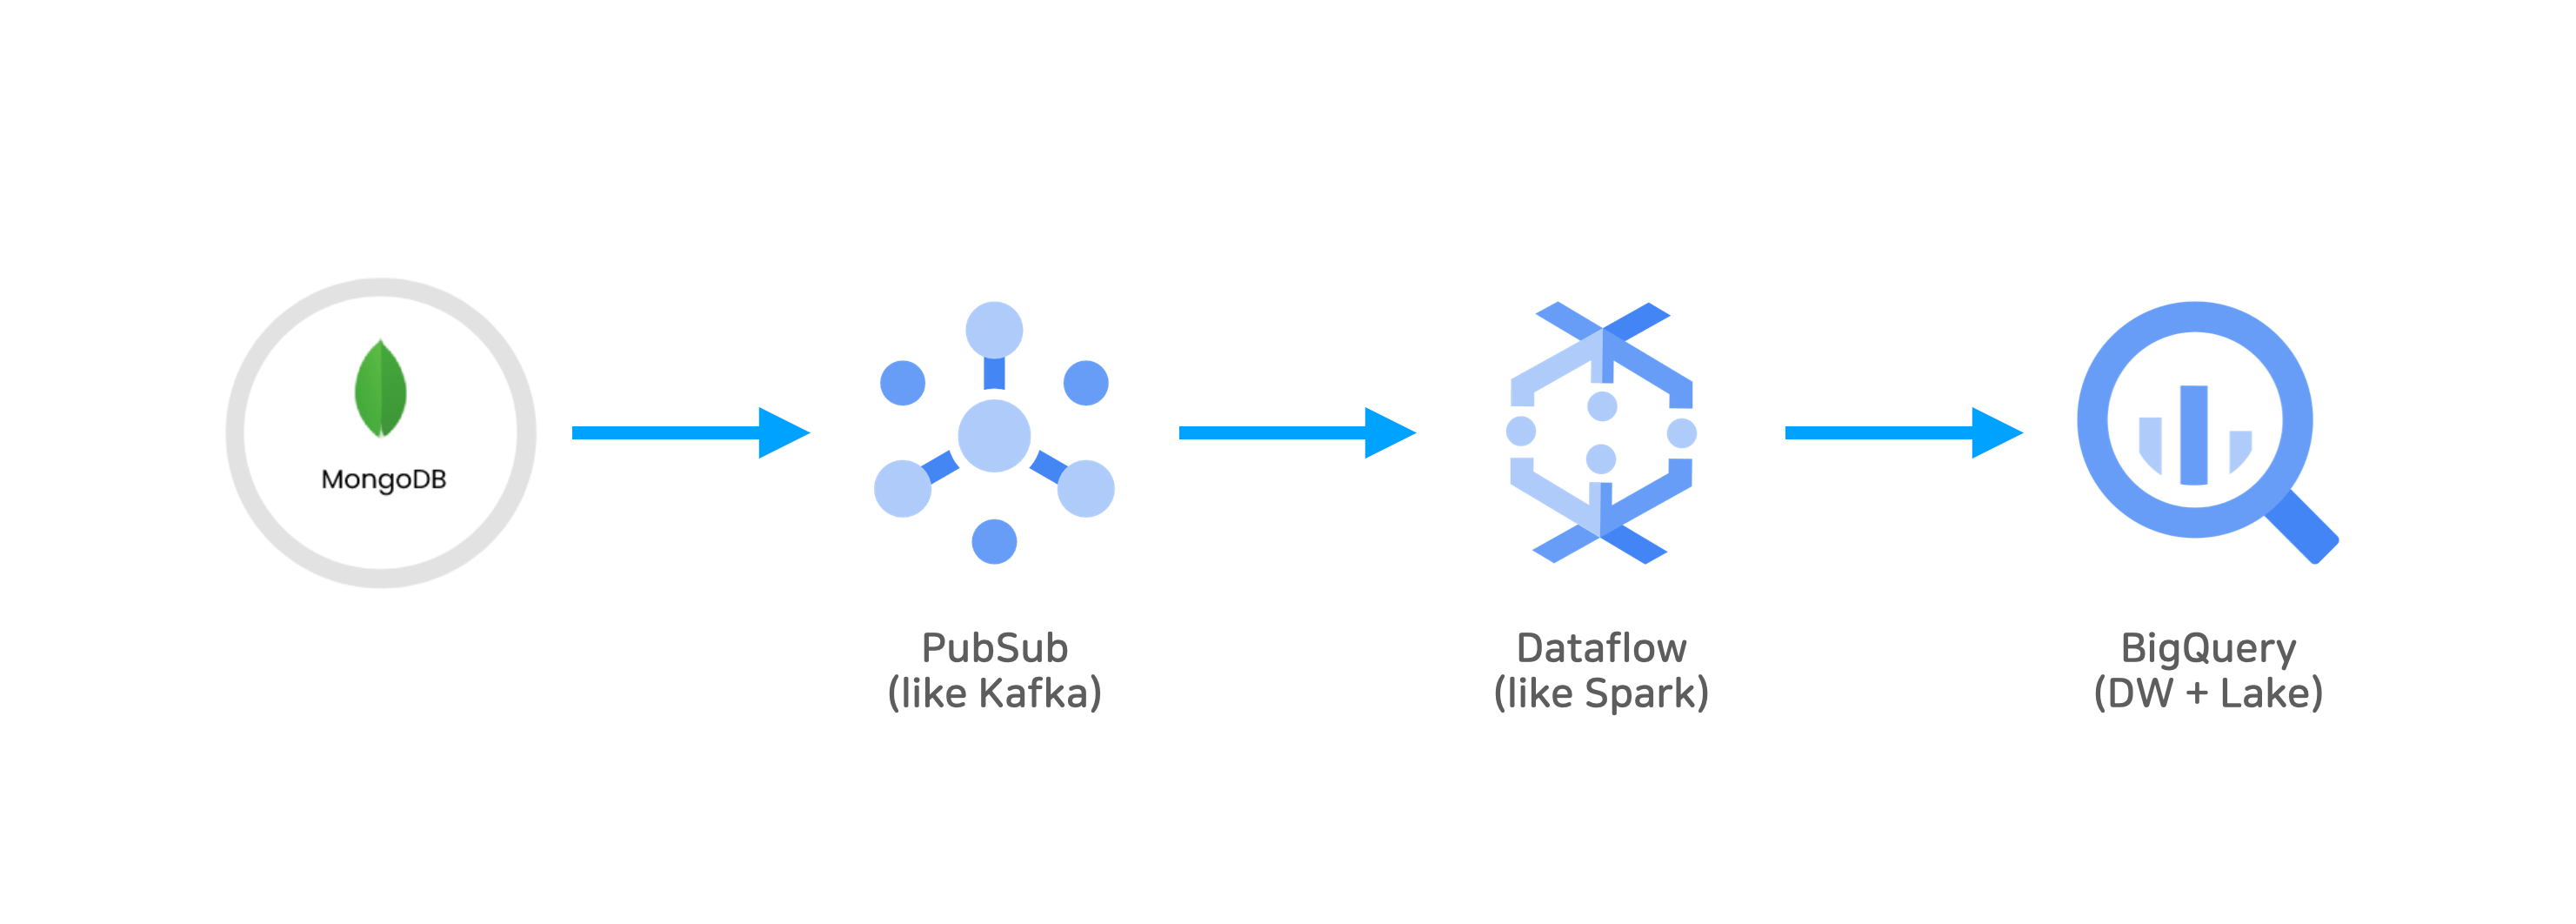
특히 MongoDB Change Stream 기능을 이용하여 변경 이벤트를 실시간으로 분석 시스템에 전달할 수 있다는 점으로 MongoDB와 BigQuery의 연계성을 강조했습니다.
MongoDB 핸즈온 세션
MongoDB Atlas는 AWS나 GCP, Azure 등의 퍼블릭 클라우드와 함께 사용할 수 있는 멀티 클라우드를 지원하는 관리형 MongoDB 클라우드 서비스입니다.
쉽게 DB 클러스터를 구축하고 배포하는 것뿐만 아니라 AWS, GCP와의 연계 등 하나의 클러스터에서 각각의 노드를 서로 다른 클라우드로 배포할 수 있는 것이 강점입니다.
동일한 데이터베이스 노드를 각기 다른 클라우드에 배포할 수 있다는 것이 큰 장점입니다.
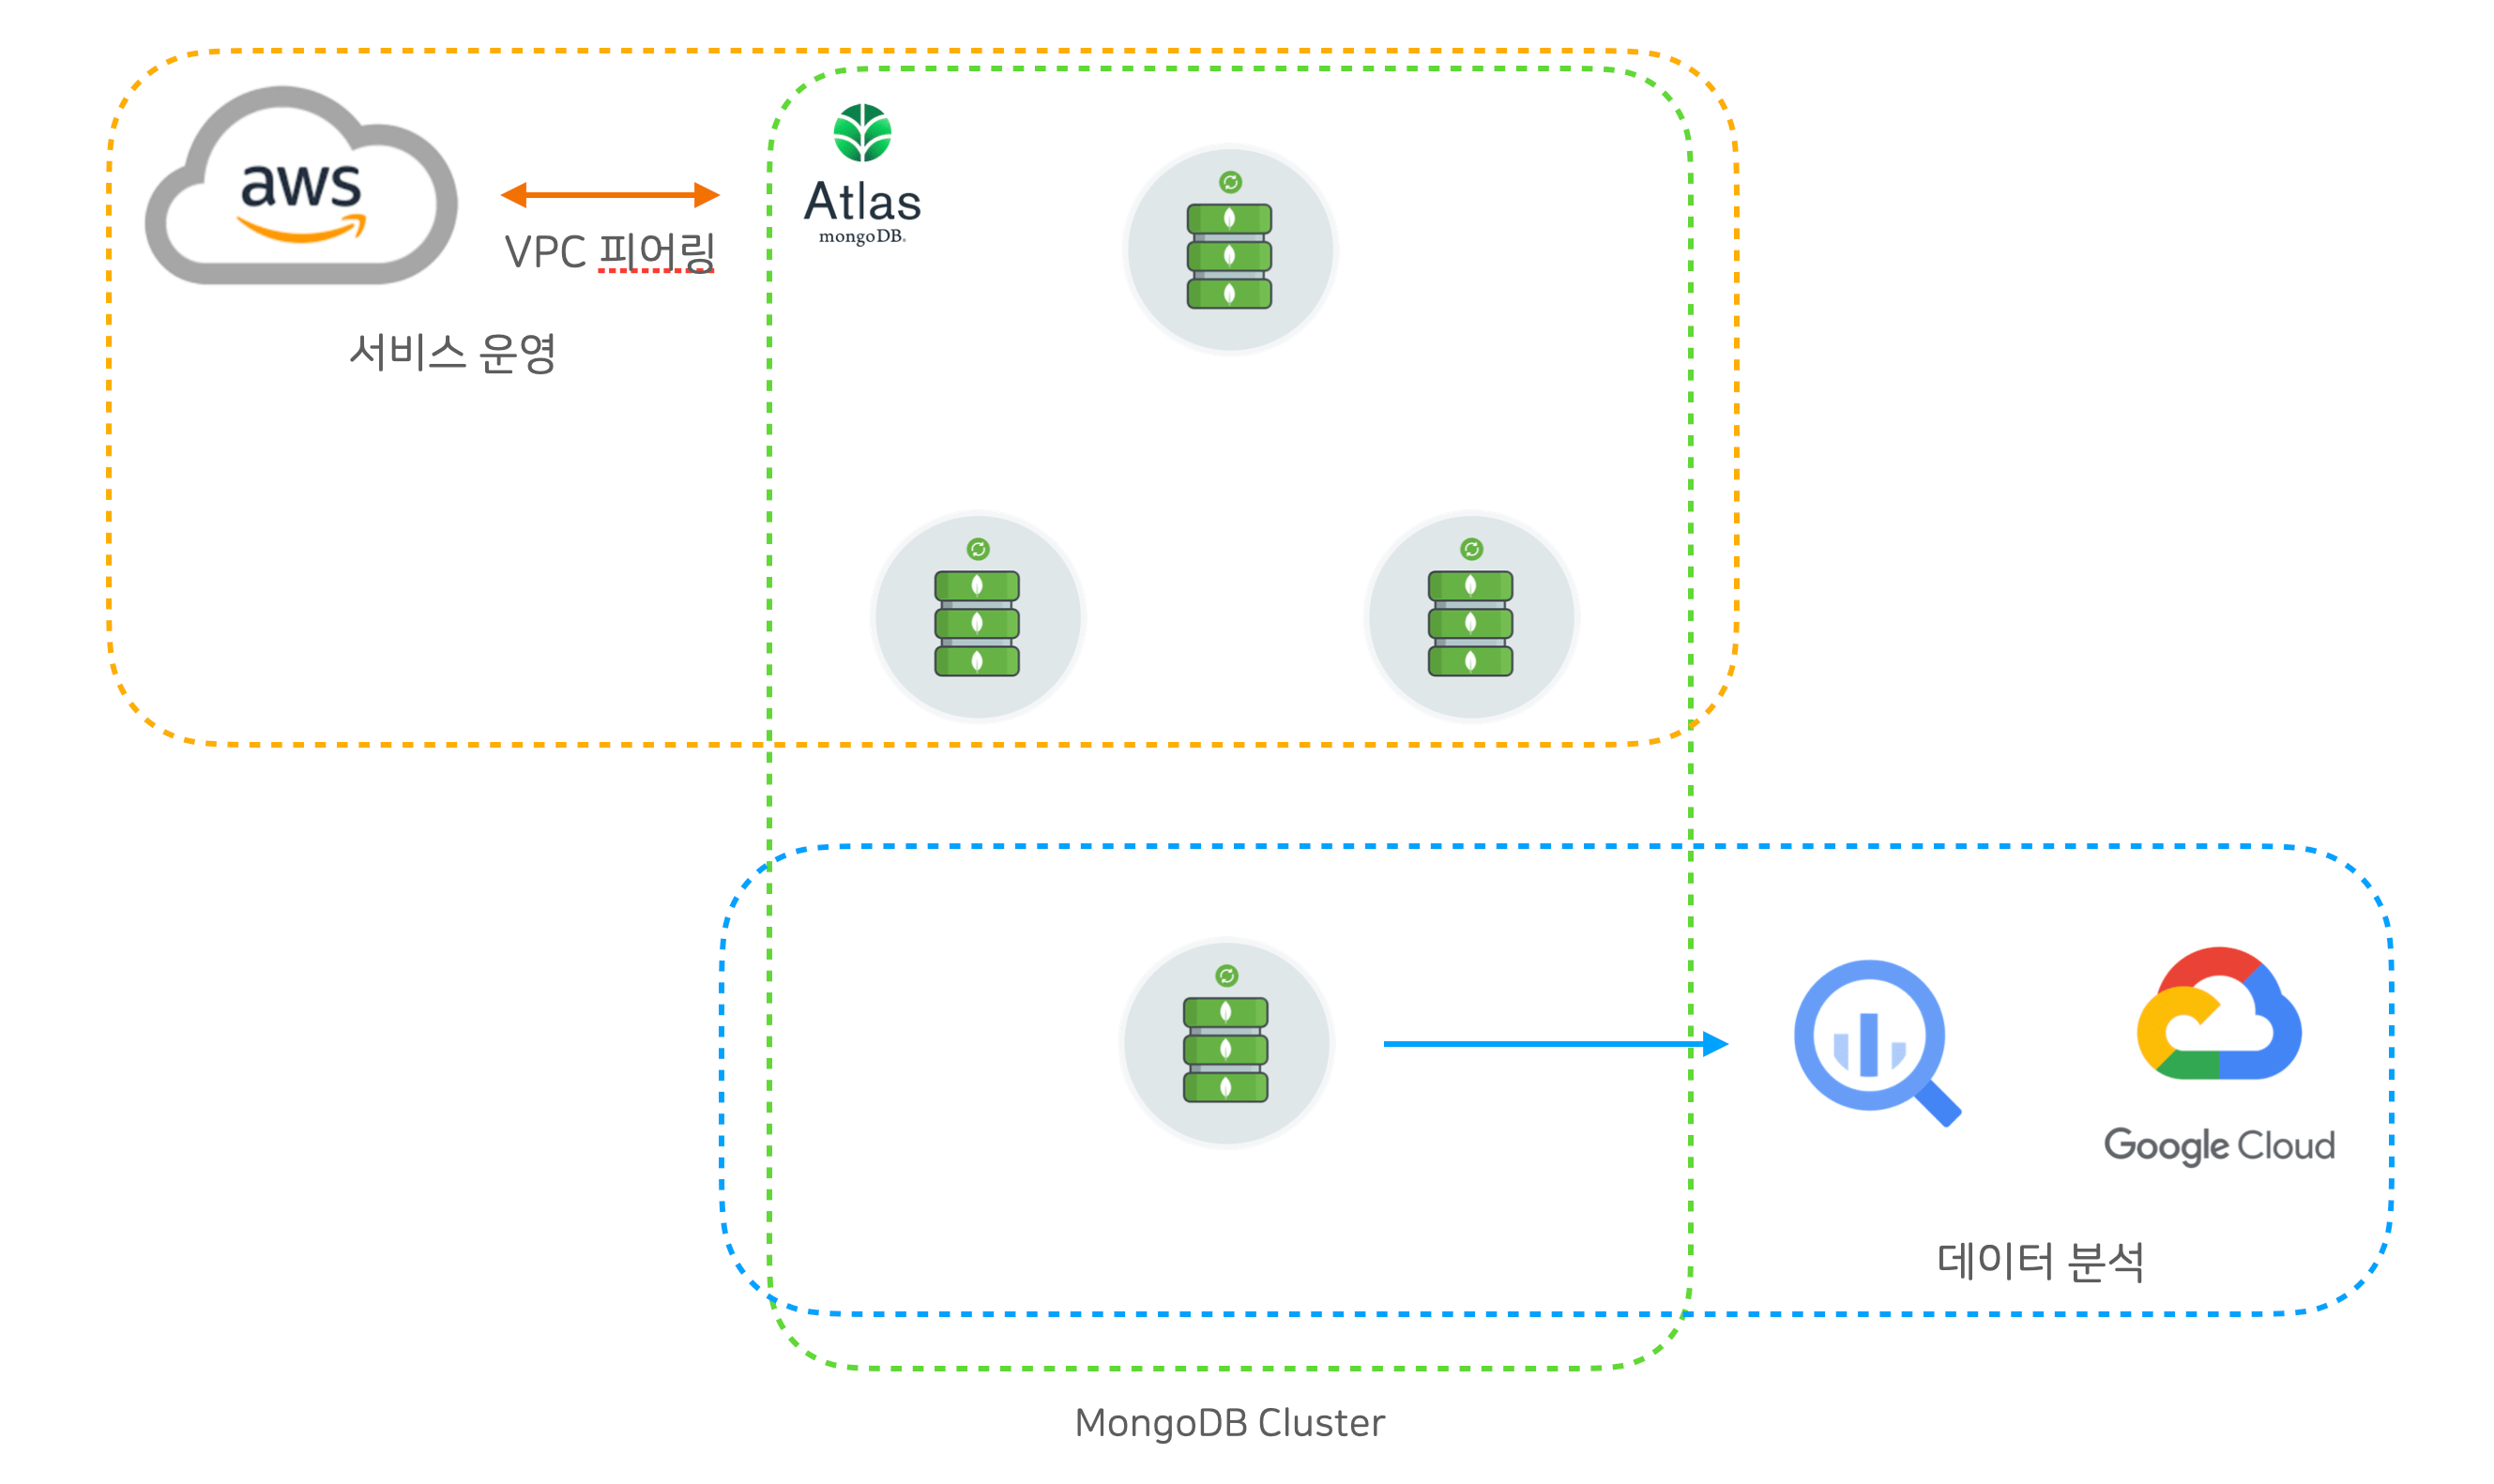
직접 Atlas에서 클러스터를 배포하고, 간단한 MongoDB 실습까지 진행했습니다.
그동안 온라인을 통해서 기승전 Atlas였던 MongoDB의 웨비나들은 실습까지는 어려운 부분이 많았지만, 드디어 오프라인 세션이 열리면서 실습을 해볼 수 있는 환경이 마련된 것이 참 좋았습니다.
오랜만에 오프라인 행사여서 그런지 MongoDB Korea에서 굿즈도 많이 준비해 주셨고, 함께한 지인분이 2등 선물에 당첨되는 등 여러 가지 재미있는 순간들이 있었습니다.
그리고 DB 오픈 카톡방에서 활동하시는 다른 DBA분들과 마주하여 다양한 이야기를 나눌 수 있었던 기회가 된 것 같아 좋은 경험이었습니다.
이상 MongoDB Developer Workshop 후기였습니다.
읽어 주셔서 감사합니다.