MongoDB Transaction Management
MongoDB의 트랜잭션
MongoDB는 여러 연산과 컬렉션, 데이터베이스, 도큐먼트, 그리고 샤드에 걸친 ACID 트랜잭션을 지원합니다. 공식 문서는 레플리카 셋과 샤드 클러스터 양쪽에서 분산 트랜잭션이 동작하며, 설정한 Read Concern과 Write Concern에 따라 원자성, 일관성, 격리성, 내구성을 제공한다고 적습니다. 다중 도큐먼트 트랜잭션은 4.0에서 레플리카 셋에 먼저 들어왔고 4.2에서 샤드 클러스터로 확장됐지만, 두 버전 모두 지원이 끝났습니다. 아래 내용은 MongoDB 8.0 문서를 기준으로 합니다.
MongoDB는 WiredTiger 스토리지 엔진을 사용합니다. WiredTiger는 애초에 NoSQL 전용으로 설계된 엔진이 아니었기 때문에 RDBMS에 가까운 특성을 여럿 보여줍니다.
그렇다고 MongoDB를 관계형 데이터베이스처럼 쓰는 것이 좋은 선택은 아닙니다. 단일 도큐먼트에 대한 연산은 그 자체로 원자적이고, 임베디드 도큐먼트와 배열로 데이터 사이의 관계를 한 도큐먼트 안에 담을 수 있습니다. 공식 문서도 여러 도큐먼트와 컬렉션으로 정규화하는 대신 이 방식을 쓰면 실무의 많은 경우에 다중 도큐먼트 트랜잭션이 필요하지 않다고 적습니다. 같은 문서는 분산 트랜잭션이 단일 도큐먼트 쓰기보다 비용이 크므로, 트랜잭션을 쓸 수 있다는 사실이 스키마 설계를 대신하지는 못한다고 덧붙입니다.
그래서 트랜잭션은 도큐먼트 설계만으로 원자성을 확보할 수 없을 때 꺼내는 수단입니다. 애플리케이션 요건상 모든 데이터를 한 도큐먼트에 담을 수 없거나, 데이터가 여러 컬렉션에 나뉘어야 하는데 그 전체에 ACID 보장이 필요한 상황이 여기에 해당합니다.
분산 트랜잭션의 원자성은 다음과 같이 동작합니다.
- 트랜잭션은 변경을 전부 적용하거나 전부 되돌립니다.
- 커밋 전에는 트랜잭션 안의 변경이 트랜잭션 밖에서 보이지 않고, 커밋하면 보입니다. 중단되면 밖에서 한 번도 보이지 않은 채 폐기됩니다.
- 트랜잭션이 여러 샤드에 쓰는 경우, 밖에서 들어온 읽기가 모든 샤드에서 변경이 보일 때까지 기다리지는 않습니다. Read Concern
"local"로 읽으면 샤드 A의 쓰기만 보이고 샤드 B의 쓰기는 아직 보이지 않는 상태를 읽을 수 있습니다. - 커밋하지 않은 트랜잭션이 WiredTiger 캐시를 과도하게 쓰면 트랜잭션이 중단되고 쓰기 충돌 오류를 반환합니다. 캐시에 결코 들어갈 수 없는 크기라면
TransactionTooLargeForCache오류를 반환합니다.
MongoDB는 RDBMS처럼 READ-UNCOMMITTED, READ-COMMITTED, REPEATABLE-READ, SERIALIZABLE 네 단계 중에서 골라 쓰는 격리 수준 설정을 제공하지 않습니다. 대신 트랜잭션마다 Read Concern을 "local", "majority", "snapshot" 중에서 고르고, 그 선택이 격리 수준의 역할을 합니다.
쓰기 충돌 (Write Conflict)
여러 사용자가 동시에 같은 도큐먼트를 업데이트하려고 하면 쓰기 충돌(WriteConflict)이 발생합니다. 트랜잭션 밖의 쓰기라면 대개 이 문제를 신경 쓰지 않아도 됩니다. WiredTiger API가 동시성 위반으로 쓰기 충돌을 감지할 때마다 WriteConflict 지표를 올리고, MongoDB가 충돌 없이 완료될 때까지 내부적으로 업데이트를 재시도하기 때문입니다. 다만 쓰기 충돌이 잦으면 애플리케이션 응답이 지연될 수 있으므로 그 원인을 찾아야 합니다.
일반적으로 RDBMS에서는 두 개의 세션이 하나의 레코드에 변경 작업이 발생하는 경우 아래와 같이 동작합니다.
먼저 들어온 세션이 먼저 업데이트를 진행하고, 업데이트를 진행하는 동안 두 번째 세션은 명령 자체를 취소하지 않고 Lock wait에 걸려 있다가, 1번 세션의 작업이 끝난 후에 순차적으로 진행됩니다.
반면 MongoDB의 경합 과정은 조금 다릅니다.
MongoDB는 변경하고자 하는 도큐먼트가 이미 다른 커넥션이 Lock을 건 상태라면, 즉시 업데이트 명령을 취소합니다. 이때 스토리지 엔진은 WriteConflictException이라는 에러를 반환합니다. 이러한 경우 업데이트를 실행했던 세션은 WriteConflictException을 받고 같은 업데이트 명령을 재시도합니다. 이러한 과정은 MongoDB 서버 프로세스 내부에서만 실행되며, 애플리케이션 단에서는 이런 재시도가 있었는지 알 수 없습니다.
아래는 WriteConflict가 발생했을 때의 예시입니다.
coll_name.update( { _id: 2 },{ $set: { a: 7 } });
WriteCommandError({
   "errorLabels" : [
       "TransientTransactionError"
   ],
   "operationTime" : Timestamp(1566906756, 1),
   "ok" : 0,
   "errmsg" : "WriteConflict",
   "code" : 112,
   "codeName" : "WriteConflict",
   "$clusterTime" : {
       "clusterTime" : Timestamp(1566906756, 1),
       "signature" : {
           "hash" : BinData(0,"AAAAAAAAAAAAAAAAAAAAAAAAAAA="),
           "keyId" : NumberLong(0)
       }
   }
})
WriteConflict가 지속적으로 발생하여 재처리 과정이 늘어나면 CPU의 사용량이 높아지며, WiredTiger 스토리지 캐시에 직접적인 부담을 주기 때문에 사용자 요청을 처리하는 성능이 떨어집니다. 쓰기 충돌이 얼마나 발생하는지는 db.serverStatus() 출력의 metrics.operation.writeConflicts 에서 확인할 수 있습니다. 공식 문서는 이 값을 쓰기 충돌을 만난 쿼리의 누적 개수라고 설명합니다. 이 값이 계속 늘어난다면 컬렉션 모델을 수정해 충돌을 줄이는 편이 좋습니다.
위 예시처럼 트랜잭션 안에서 쓰기 충돌이 나면 오류에 TransientTransactionError 라벨이 붙습니다. 트랜잭션 안의 개별 쓰기는 retryWrites 값과 무관하게 재시도되지 않고, 트랜잭션 전체를 다시 실행해야 합니다. 드라이버의 Callback API는 트랜잭션을 시작하고 지정한 연산을 실행한 뒤 커밋까지(오류가 나면 중단까지) 처리하면서 TransientTransactionError 와 UnknownTransactionCommitResult 재시도 로직을 포함합니다. Core API는 시작과 커밋을 직접 호출해야 하고 이 두 오류의 재시도 로직을 포함하지 않으므로, 애플리케이션이 재시도를 직접 구현해야 합니다.
NOTE — MongoDB 6.2부터는
TransactionTooLargeForCache오류를 받으면 서버가 트랜잭션을 재시도하지 않습니다. 캐시가 너무 작아 재시도해도 실패할 가능성이 높다는 뜻입니다. 기준값을 정하는transactionTooLargeForCacheThreshold의 기본값은0.75여서, 트랜잭션이 캐시의 75%를 넘게 쓰면 재시도 대신 이 오류를 반환합니다.
단일 도큐먼트 트랜잭션 (Single Document Transaction)과 다중 도큐먼트 트랜잭션 (Multi Document Transaction)
단일 도큐먼트 트랜잭션이란 단일 도큐먼트의 변경에 대해서는 원자 단위의 처리가 보장된다는 것을 의미합니다. RDBMS의 데이터 모델에서는 서로 관계가 있는 데이터들을 정규화하여 서로 다른 테이블에 저장하지만, MongoDB의 도큐먼트 데이터 모델에서는 정규화를 하지 않고 한번에 로딩되어야 하는 데이터들을 하나의 도큐먼트에 넣는 것이 유리합니다. MongoDB가 추구하는 방향에 따라 데이터 모델링을 한다면 단일 도큐먼트 트랜잭션만으로도 데이터의 정합성이 보장됩니다. 하지만 항상 조건에 맞는 상황만 있는 것은 아니어서, 다중 도큐먼트 트랜잭션이 없던 4.0 이전에는 2-Phase-Commits 같은 방법으로 애플리케이션 단에서 직접 구현해야 했습니다.
기본적으로 트랜잭션은 1분 안에 끝나야 합니다. mongod 의 transactionLifetimeLimitSeconds 로 이 한도를 바꿀 수 있고, 샤드 클러스터라면 모든 샤드 레플리카 셋 멤버에서 값을 바꿔야 합니다. 한도를 넘긴 트랜잭션은 만료된 것으로 보아 주기적인 정리 과정이 중단시킵니다. 이 한도 자체가 만료된 트랜잭션을 주기적으로 정리해 스토리지 캐시 압박을 덜어 주는 역할도 합니다.
캐시 압박이 성능을 깎지 않게 하려면 공식 문서는 두 가지를 권고합니다. 트랜잭션을 그냥 버리지 말고 명시적으로 중단하고, 트랜잭션 안의 개별 연산에서 오류를 만나면 중단한 뒤 트랜잭션을 다시 실행하는 것입니다.
단일 샤드를 대상으로 하는 트랜잭션은 레플리카 셋 트랜잭션과 성능이 비슷하지만, 여러 샤드에 걸친 트랜잭션은 비용이 더 큽니다. 샤드 클러스터 트랜잭션에서 샤드 간 일관된 스냅샷을 제공하는 것은 "snapshot" Read Concern 뿐입니다. 샤드 클러스터에서 트랜잭션을 쓰려면 writeConcernMajorityJournalDefault 가 true 여야 하고, 트랜잭션의 쓰기가 여러 샤드에 걸치는데 그중 하나라도 아비터를 가진 샤드가 끼면 MongoDB가 그 트랜잭션을 막습니다.
트랜잭션 안에서 사용할 수 있는 읽기, 쓰기 연산은 다음과 같습니다.
| Method | Command | Note |
|---|---|---|
db.collection.aggregate() |
aggregate |
$collStats, $currentOp, $indexStats, $listLocalSessions, $listSessions, $merge, $out, $planCacheStats, $unionWith 스테이지 제외 |
db.collection.countDocuments() |
$where, $near, $nearSphere 쿼리 연산자 표현식 제외. 이 메서드는 쿼리에 $match 스테이지를, 계산에 $sum 표현식을 쓴 $group 스테이지를 사용합니다 |
|
db.collection.distinct() |
distinct |
샤딩되지 않은 컬렉션에서만 사용할 수 있습니다. 샤딩된 컬렉션에서는 $group 스테이지를 쓴 집계 파이프라인을 사용합니다 |
db.collection.find() |
find |
|
db.collection.deleteOne(), deleteMany(), remove() |
delete |
|
db.collection.findOneAndDelete(), findOneAndReplace(), findOneAndUpdate() |
findAndModify |
update 또는 replace를 없는 컬렉션에 upsert: true 로 실행하면 컬렉션이 암묵적으로 생성됩니다 |
db.collection.insertOne(), insertMany() |
insert |
없는 컬렉션에 실행하면 컬렉션이 암묵적으로 생성됩니다 |
db.collection.updateOne(), updateMany(), replaceOne() |
update |
없는 컬렉션에 실행하면 컬렉션이 암묵적으로 생성됩니다 |
db.collection.bulkWrite() 및 각종 Bulk 연산 메서드 |
없는 컬렉션에 실행하면 컬렉션이 암묵적으로 생성됩니다 |
표에서 눈여겨볼 점이 몇 가지 있습니다. 없는 컬렉션을 암묵적으로 생성하는 동작에는 버전 조건이 붙지 않습니다. geoSearch 명령은 목록에 없습니다. db.collection.save(), insert(), update(), count() 는 mongosh에서 deprecated로 표시돼 있어서, 목록에도 insertOne(), insertMany(), updateOne(), updateMany(), countDocuments() 같은 대체 메서드가 올라가 있습니다. 전체 목록은 Transactions and Operations 문서에서 확인할 수 있습니다.
샤드 키 값을 바꾸는 작업도 트랜잭션 안에서 할 수 있습니다. 샤드 키 필드가 변경 불가능한 _id 가 아니라면, 단일 도큐먼트 update 또는 findAndModify로 샤드 키 값을 변경할 수 있습니다.
MongoDB의 격리 수준
앞에서 MongoDB가 RDBMS식 격리 수준 설정을 제공하지 않고 Read Concern이 그 역할을 한다고 했습니다. 스냅샷 격리는 트랜잭션을 연 시점의 값을 트랜잭션이 끝날 때까지 보여주는 동작을 말합니다. 첫 번째 세션의 트랜잭션이 진행되는 동안 두 번째 세션이 같은 도큐먼트를 업데이트해도, 첫 번째 세션은 트랜잭션을 시작했을 때의 값을 계속 읽습니다.
레플리카 셋에서는 Read Concern이 "local" 이어도 트랜잭션을 연 시점의 스냅샷에서 읽는, 더 강한 격리가 관찰될 수 있습니다. 반면 샤드 클러스터에서는 "local" 과 "majority" 모두 샤드 전체에 걸쳐 같은 스냅샷을 본다고 보장하지 않으므로, 스냅샷 격리가 필요하면 "snapshot" 을 지정해야 합니다.
"snapshot" 이 과반 커밋된 데이터의 스냅샷을 돌려주는 것은 트랜잭션을 Write Concern "majority" 로 커밋할 때뿐입니다. 커밋에 "majority" 를 쓰지 않으면 "snapshot" 이 과반 커밋 데이터의 스냅샷을 읽는다는 보장은 사라집니다. 샤드 클러스터에서는 "snapshot" 이 보는 스냅샷이 샤드 간에 동기화됩니다.
NOTE — 트랜잭션 안의 읽기가 언제나 최신 상태를 본다고 가정하면 안 됩니다. 공식 문서는 트랜잭션 안의 읽기가 오래된 데이터를 돌려줄 수 있고(stale read), 다른 트랜잭션이 커밋한 쓰기나 트랜잭션 밖의 쓰기를 본다고 보장되지 않는다고 적습니다. 특정 도큐먼트를 확실히 잡아 두어야 한다면
findOneAndUpdate로 도큐먼트를 변경해 잠금을 획득하는 방법을 쓸 수 있습니다.
명시적인 트랜잭션을 열지 않은 데이터 변경은 도큐먼트 하나를 변경할 때마다 내부적으로 트랜잭션이 커밋됩니다. 배치로 실행하는 업데이트나 삭제도 내부에서는 개별 트랜잭션으로 처리됩니다. 그래서 처리 도중에 장애가 나서 멈추더라도 앞서 처리한 도큐먼트들은 롤백되지 않습니다. 대신 도큐먼트당 트랜잭션 유지 시간이 짧아, RDBMS에서 긴 트랜잭션이 유발하는 성능 저하는 거의 나타나지 않습니다.
반면에 읽기 쿼리는 도큐먼트 한 건을 읽을 때마다 트랜잭션을 여는 구조가 아니라 일정 단위로 트랜잭션을 시작하고 완료합니다. 도큐먼트를 읽을 때마다 트랜잭션을 여닫으면 성능이 떨어지기 때문에, 읽기 트랜잭션은 쓰기와 다른 방식으로 동작합니다.
Read & Write Concern, Read Preference
대부분의 RDBMS는 단일 노드로 작동하는 아키텍처를 기본으로 합니다. 반면 MongoDB는 분산 처리를 기본 아키텍처로 선택했기 때문에 레플리카 셋 멤버 간의 동기화까지 제어할 수 있습니다. 필요한 동기화 수준, 즉 ACID의 Durability 속성을 어디까지 요구할지 고르는 수단이 Read Concern과 Write Concern입니다. RDBMS는 디스크 동기화 처리를 서버 단위로 일괄 설정하지만, MongoDB는 클라이언트에서 쿼리 단위로 다르게 설정할 수 있습니다.
Read Concern은 읽기 연산을 다룬 이전 글에서도 설명한 적이 있습니다.
Read Concern
MongoDB 서버는 분산 처리 구조라서 여러 레플리카 멤버 중 어떤 멤버를 고르느냐에 따라 같은 find 쿼리의 결과가 달라질 수 있습니다. 복제가 비동기로 동작하는 최종 일관성(Eventual Consistency) 모델이기 때문입니다. 데이터를 읽는 쿼리 입장에서는 이 성질이 곧 롤백 가능한 값이나 오래된 값을 읽을 위험이 됩니다. 동기화가 진행되는 중에도 읽기 일관성을 유지하도록 제공하는 것이 Read Concern이며, Write Concern과 달리 레플리카 셋 간의 동기화만 제어합니다.
Read Concern은 다섯 가지 레벨이 있습니다.
- local: 프라이머리와 세컨더리 읽기의 기본값입니다. 데이터가 레플리카 셋의 과반에 기록됐는지 확인하지 않고 반환하므로, 최신 데이터를 프라이머리만 가진 상태에서 프라이머리가 내려가면 그 데이터는 롤백될 수 있습니다. causally consistent session과 트랜잭션에서 쓸 수 있습니다.
- available: 과반 기록 여부를 확인하지 않고 데이터를 반환합니다. 읽은 데이터가 롤백될 수 있고, 샤딩된 컬렉션을 읽을 때는 orphaned document가 섞여 나올 수 있습니다. causally consistent session과 트랜잭션에서는 쓸 수 없습니다.
- majority: 레플리카 셋의 과반이 확인한 데이터를 반환합니다. 장애가 나더라도 반환된 도큐먼트는 유지됩니다. 앞의 두 레벨보다 비용이 큽니다. causally consistent session과 트랜잭션에서 쓸 수 있고, WiredTiger 스토리지 엔진에서 사용할 수 있습니다.
- linearizable: 읽기가 시작되기 전에 완료된 모든 과반 확인 쓰기를 반영한 데이터를 반환합니다. 프라이머리에만 지정할 수 있고, causally consistent session과 트랜잭션에서는 쓸 수 없습니다.
"majority"나"local"보다 상당히 느릴 수 있습니다. - snapshot: 최근 특정 시점에 샤드 전체에 걸쳐 보이는 과반 커밋 데이터를 반환합니다. 샤드 클러스터 트랜잭션에서 샤드 간 일관된 스냅샷을 보장하는 유일한 레벨입니다. capped collection을 읽을 때는 사용할 수 없습니다.
NOTE —
linearizable을 쓸 때는maxTimeMS를 함께 지정하라고 공식 문서가 권고합니다. 데이터를 가진 멤버의 과반을 쓸 수 없는 상황에서 요청이 무한히 대기하는 대신 오류로 끝나게 만들기 때문입니다.
db.restaurants.find( { _id: 5 } ).readConcern("linearizable").maxTimeMS(10000)
예전에는 PSA(Primary-Secondary-Arbiter) 구성에서 스토리지 캐시 압박을 피하려고 enableMajorityReadConcern 을 false 로 두어 "majority" Read Concern을 끌 수 있었습니다. MongoDB 5.0부터는 스토리지 엔진이 개선되면서 이 설정을 바꿀 수 없고 항상 true 입니다.
MongoDB에서 Read Concern 모드로 쿼리를 실행하면 오직 레플리카 셋의 OpLog 동기화 여부에만 의존해서 쿼리의 Read Concern을 처리합니다. 프라이머리 멤버는 각 세컨더리 멤버가 OpLog의 어디까지 동기화했는지를 알고 있습니다. 세컨더리 멤버가 프라이머리의 OpLog를 조회할 때마다 자신의 동기화 위치를 프라이머리에 보고하는 방식입니다. 프라이머리는 쿼리 요청이 오면 그 정보를 참고해 설정 값이 요구하는 멤버들이 자신의 OpLog와 같은 상태인지 확인한 뒤 쿼리를 처리하고, 아직 따라오지 못했다면 원하는 수준까지 동기화될 때까지 기다립니다.
Read Concern은 클라이언트, 데이터베이스, 컬렉션 세 레벨에서 설정할 수 있습니다. 다만 트랜잭션 안에서는 컬렉션과 데이터베이스 레벨의 Read Concern이 무시되고 트랜잭션 레벨의 Read Concern이 쓰입니다. 트랜잭션 레벨이 비어 있으면 세션 레벨, 세션 레벨도 비어 있으면 클라이언트 레벨을 따르는데, 클라이언트 레벨의 기본값은 프라이머리 읽기에 대해 "local" 입니다. 레플리카 셋과 샤드 클러스터는 전역 기본 Read Concern도 지원하며, setDefaultRWConcern 으로 설정합니다.
Write Concern
Write Concern은 데이터 변경 요청에 응답을 돌려줄 시점을 결정하는 옵션입니다. insert, update, delete 작업에 설정할 수 있고, Read Concern과 마찬가지로 클라이언트, 데이터베이스, 컬렉션 세 레벨에서 설정할 수 있습니다. 명시적인 트랜잭션을 쓰는 경우에는 개별 쓰기에 Write Concern을 지정하면 오류가 나고, 커밋 시점에 트랜잭션 레벨의 Write Concern이 적용됩니다.
Write Concern은 { w: <value>, j: <boolean>, wtimeout: <number> } 형태로 지정합니다.
w: <숫자>: 쓰기가 전파돼야 하는mongod인스턴스의 수입니다.w: 1은 스탠드얼론mongod또는 레플리카 셋 프라이머리까지만 전파되면 응답하므로, 세컨더리로 복제되기 전에 프라이머리가 내려가면 데이터가 롤백될 수 있습니다.w: 0은 쓰기 확인을 아예 요청하지 않지만 소켓 예외나 네트워크 오류는 애플리케이션에 전달될 수 있습니다.w: "majority": 데이터를 가진 투표 멤버의 과반이 자신의 OpLog에 변경을 내구성 있게 기록했음을 확인합니다. 멤버 수가 자주 바뀌는 환경에서도 값을 고쳐 줄 필요가 없습니다.j:j: true는w로 지정한mongod인스턴스가 디스크의 저널에 기록했음을 확인받습니다. 저널이 켜져 있으면w: "majority"가j: true를 함의할 수 있고, 이 동작은writeConcernMajorityJournalDefault설정이 결정합니다. 저널링 없이 실행 중인mongod에j: true를 주면 오류가 납니다.wtimeout: 프라이머리에서 성공한 뒤 Write Concern을 충족할 때까지의 제한 시간(밀리초)입니다.w가 1 이하면 적용되지 않습니다. 제한을 넘기면 쓰기 우려 오류를 반환하지만, 그때까지 성공한 데이터 변경을 되돌리지는 않습니다. 지정하지 않으면 충족 불가능한 Write Concern에서 무한히 대기합니다.
암묵적 기본 Write Concern은 w: "majority" 입니다. 예외가 하나 있습니다. 아비터가 있고 데이터를 가진 투표 멤버 수가 투표 멤버 과반보다 많지 않은 구성이라면 기본값이 w: 1 입니다. 예를 들어 데이터 멤버 2대와 아비터 1대인 구성은 w: 1, 데이터 멤버 4대와 아비터 1대인 구성은 w: "majority" 가 기본값입니다. 전역 기본 Write Concern 역시 majority 입니다.
MongoDB 8.0부터 { w: "majority" } 쓰기는 데이터를 가진 멤버의 과반이 OpLog 엔트리를 내구성 있게 기록한 시점에 응답을 돌려줍니다. 멤버들은 그 뒤 자신의 로컬 OpLog를 읽어 변경을 비동기로 적용합니다. 이전 릴리스에서는 멤버가 쓰기를 적용할 때까지 기다린 뒤 응답했습니다.
저널 로그는 클라이언트가 변경한 데이터를 RDBMS의 트랜잭션 로그처럼 디스크에 먼저 기록해, 서버가 비정상 종료될 때의 데이터 손실을 막습니다. 데이터 파일에 쓰기 전에 저널에 먼저 남기는 방식입니다. 다만 저널 기록만으로 최상의 일관성이 보장되지는 않습니다. 단일 노드는 디스크 동기화만 신경 쓰면 되지만 레플리카 셋에서는 세컨더리 멤버의 동기화까지 고려해야 하기 때문입니다.
Read Preference
Read Preference는 읽기 작업을 어느 멤버에서 처리할지 정하는 설정입니다. 세컨더리가 동기화해 둔 데이터를 예비 프라이머리 후보로만 두지 않고 읽기 처리에도 쓰게 만들어, 프라이머리에 들어오는 부하를 줄일 수 있습니다.
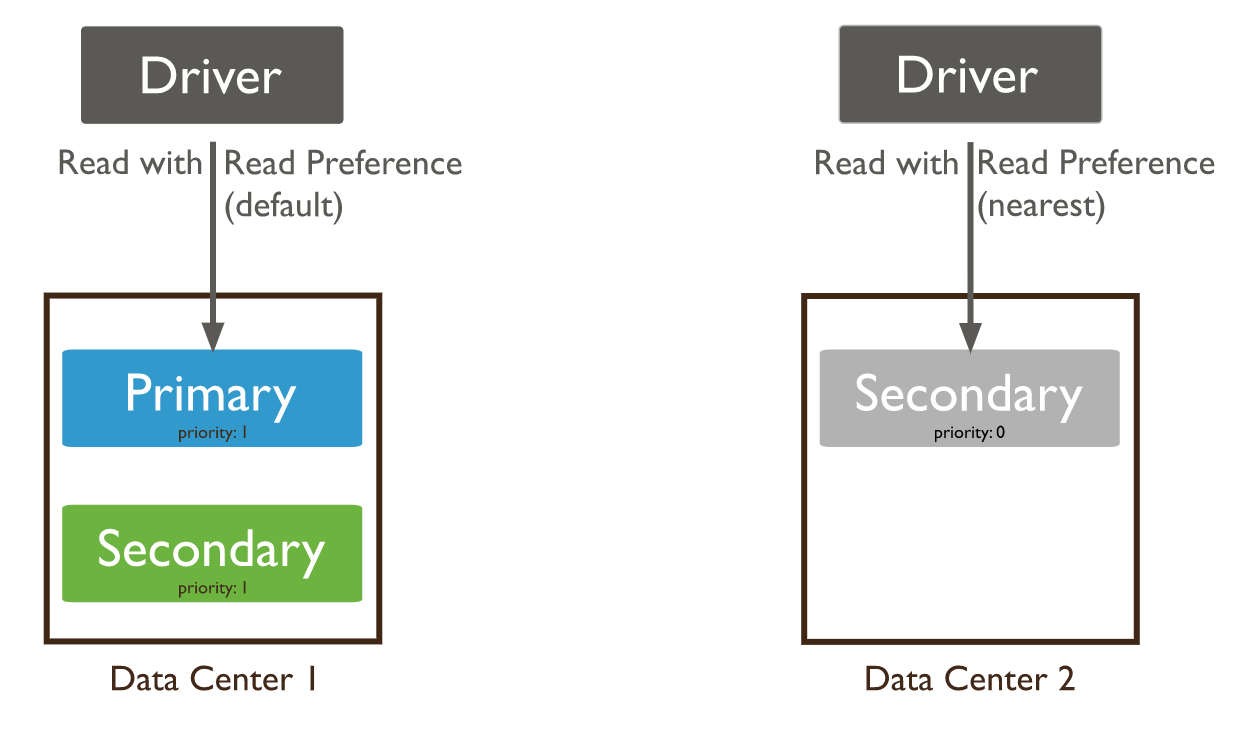
read Preference
기본값일 때는 모든 작업이 Primary에서 동작합니다. 하지만 Read Preference 설정을 하게 되면 읽기 작업을 Secondary에서 할 수 있습니다. 읽기 연산을 포함하는 트랜잭션은 Read Preference가 primary 여야 하며, 한 트랜잭션의 모든 연산은 같은 멤버로 라우팅되어야 합니다.
Read Preference는 5가지 모드가 있습니다.
- primary: 기본값이며, 모든 읽기를 현재 프라이머리에서 처리합니다.
- primaryPreferred: 대부분의 상황에서 프라이머리에서 읽지만, 프라이머리를 쓸 수 없으면 세컨더리에서 읽습니다.
- secondary: 모든 읽기를 세컨더리에서 처리합니다.
- secondaryPreferred: 보통 세컨더리에서 읽습니다. 레플리카 셋이 프라이머리 하나뿐이고 다른 멤버가 없으면 프라이머리에서 읽습니다.
- nearest: 프라이머리와 세컨더리를 구분하지 않고, 지정한 지연 시간 기준을 만족하는 멤버 중 무작위로 하나를 골라 읽습니다. 이때 지연 시간 계산에는
localThresholdMS연결 옵션,maxStalenessSeconds, 지정한 태그 셋 목록이 반영됩니다.
Read Preference는 클라이언트 드라이버에서 설정하는 값이라 언어와 드라이버에 따라 방법이 조금씩 다릅니다. 언어별 설정 방법은 MongoDB 드라이버 문서에서 확인할 수 있습니다. 드라이버와 무관하게 통하는 방법은 연결 문자열에 옵션으로 넣는 것입니다. 값은 대소문자를 구분합니다.
mongodb://<연결 주소>/?replicaSet=myRepl&readPreference=nearest
커서나 컬렉션을 불러올 때 Read Preference 옵션을 사용하여 읽기 분산을 처리할 수도 있습니다.
MongoDB의 복제는 비동기 방식으로 처리되므로 세컨더리 멤버를 통해 무거운 쿼리를 많이 돌게 되면 복제 지연이 발생할 수도 있습니다. 하지만 복제 지연에 민감하지 않거나, 복잡한 연산으로 프라이머리에 부하를 많이 줄 수 있는 통계 작업이 있다면 세컨더리 노드를 활용하는 것도 좋은 방법입니다.
maxStalenessSeconds 를 설정하면 드라이버와 mongos 라우터가 지정한 시간보다 복제 지연이 심한 세컨더리를 읽기 대상에서 제외합니다. 기본적으로는 최대 지연 제한이 없어서 클라이언트가 세컨더리의 지연을 고려하지 않습니다. 최솟값은 90초이고, 0과 90 사이의 값을 주면 오류가 납니다. primary 모드는 태그 셋 목록이나 maxStalenessSeconds 와 함께 쓸 수 없습니다. 둘을 같이 지정하면 드라이버가 오류를 냅니다. 읽기 설정에 maxStalenessSeconds 와 태그 셋 목록을 함께 주면 클라이언트는 지연으로 먼저 걸러낸 뒤 태그로 걸러냅니다.
NOTE — 샤드 클러스터에서 샤드당 두 멤버로 읽기를 보내고 먼저 응답한 쪽 결과를 쓰던 hedged read는 MongoDB 8.1에서 제거됐습니다. 쿼리에 hedge 옵션을 지정하면 MongoDB가 쿼리는 실행하되 옵션을 무시하고 경고를 남깁니다.
레플리카 셋의 태그(tag) 기능을 이용해 레플리카 셋의 지역을 나눠 여러 지역에서의 고가용성을 확보할 수도 있습니다. 태그와 nearest 옵션을 사용해 Read Preference를 통한 실제 거리상으로 가까운 지역의 레플리카 멤버를 선택하여 쿼리할 수도 있습니다.
참고 자료
도서: Real MongoDB
MongoDB Manual: https://www.mongodb.com/docs/manual/