회원 가입 및 로그인을 위한 테이블 설계
《개발자의 글쓰기》라는 책을 읽다 보면 이런 에피소드가 나옵니다. 문장을 주고 특정 핵심 단어로 문장을 요약해 보라고 했을 때 DBA는 추려낸 단어에서 중복된 단어는 제거해야 한다고 말한다고 하죠. 이처럼 DBA는 습관적으로 데이터 중복에 민감함을 드러냅니다.
데이터베이스 이론서는 대부분 정규화의 필요성을 강조합니다. 정규화로 데이터 중복을 피하고, 무손실 분해와 종속성 유지 분해의 조건이 갖춰지면 데이터 무결성과 종속성을 유지할 수 있습니다. 보이스 코드 정규화(BCNF)까지 구현할 수 있으면 가장 좋지만, 최소 3정규화까지는 해야 구조에서 오는 데이터 중복을 막을 수 있습니다. 데이터 중복은 불필요한 공간을 차지하는 문제만이 아니라 데이터베이스 I/O 처리에도 문제를 불러오기 때문에, 중복을 제거하는 일은 데이터베이스를 다루는 데 중요한 부분입니다.
데이터베이스 성능은 결국 I/O에서 갈리고, 데이터 중복은 읽기와 쓰기 양쪽의 I/O를 늘립니다. 그래서 DBA와 DA는 I/O를 줄이려고 정규화를 하고 SQL 튜닝을 합니다.
데이터의 속성에 따라 정규화할 필요가 있다고 이론서는 늘 말합니다. 하지만 그 속성을 어떻게 나누고 분류할지 결정하는 것은 어려운 문제입니다. DBA나 DA가 없는 상황에서 개발자가 서비스에 필요한 수준으로만 설계한 DB는 이런 기본 원칙이 잘 지켜지지 않습니다. 성능 문제가 드러난 시점에는 구조가 이미 얽히고 꼬여 있어서 손을 댈 수 없는 경우가 많습니다.
1:1 항목은 굳이 테이블을 분리할 필요가 없다고 말하는 분도 있습니다. 하지만 데이터가 많아지고 서비스가 커지면 한 테이블에 컬럼이 너무 많이 담겨 문제가 되는 상황이 반드시 옵니다.
데이터베이스는 인덱스를 타든 풀스캔을 하든, 특정 값을 읽으려면 그 값이 들어 있는 행이 담긴 블록 전체를 먼저 읽습니다.
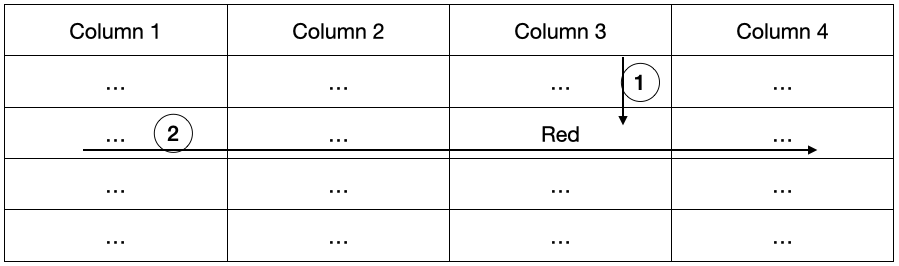
- 인덱스를 통해 해당 값이 있는 row에 도착하지만,
- Row 값의 일부분인 해당 값만 읽어오는 것이 아니라 해당 값이 있는 Row 전체 블록을 읽어옵니다.
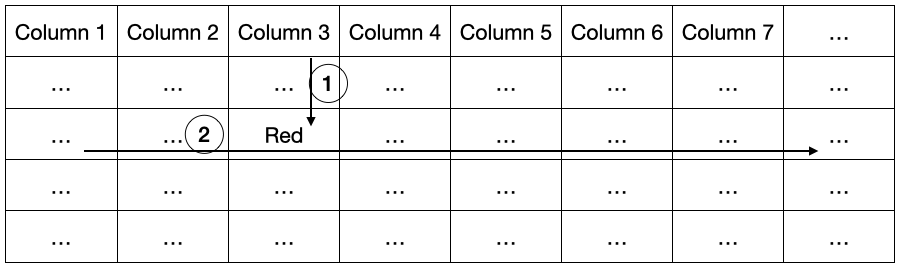
입출력의 최소 단위는 행이 아니라 이 블록이고, InnoDB에서는 페이지라고 부릅니다. 기본 크기는 16KB이며 innodb_page_size 로 정해집니다. 그래서 행이 넓어지면 한 페이지에 담기는 행 수가 줄고, 같은 건수를 읽는 데 읽어야 할 페이지가 늘어납니다. 컬럼이 많을수록 읽기가 많아진다는 말의 실제 내용이 이것입니다.
1:1 매칭이라고 해서 컬럼을 마구 늘렸다가 속성이 맞지 않는 값이 섞이고 나중에 안 쓰는 컬럼이 생기면, 구조 문제뿐 아니라 성능 이슈도 함께 따라옵니다.
컬럼이 많은 테이블의 행을 불러올 때, 비슷하게 컬럼이 많은 다른 테이블과 조인한다고 가정하면 실제 필요한 데이터보다 훨씬 많은 페이지를 읽어야 결과가 나옵니다. 데이터가 쌓일수록 점점 더 느려지는 결과를 가져옵니다.
복합 인덱스를 잘 구성하면 어느 정도는 해소됩니다. 조회에 필요한 컬럼이 인덱스 안에 모두 들어 있으면 테이블 접근 없이 인덱스만 읽는 커버링 인덱스가 되기 때문입니다. 그래도 한 테이블에 컬럼이 100개씩 있는 구조에서 성능이 잘 나오기를 바라는 것은 무리죠.
회원 테이블의 비즈니스 로직과 구조화하기
회원 테이블은 한 번 구성하면 거의 모든 서비스에서 참조하는 테이블입니다. 따라서 회원 테이블에 불필요한 데이터가 많거나 컬럼이 많으면 좋지 않습니다. 속성이 다른 데이터가 많으면 1:1로 매칭되더라도 정규화하여 분리하는 편이 낫습니다.
회원 테이블은 회원 가입과 로그인에 가장 먼저 쓰이고, 이후 서비스가 돌아가면 정산이나 통계, 서비스 이용 목록을 조회할 때 계속 쓰입니다.
모든 서비스가 이런 비즈니스 로직을 가진다는 뜻은 아니고, 일반적이고 단순한 앱 서비스를 기준으로 그려 본 것입니다. 회원 가입과 로그인은 대부분 이 로직으로 동작합니다. 그에 따라 테이블 설계도 이 로직을 커버할 수 있어야 합니다.
RDBMS 테이블 설계
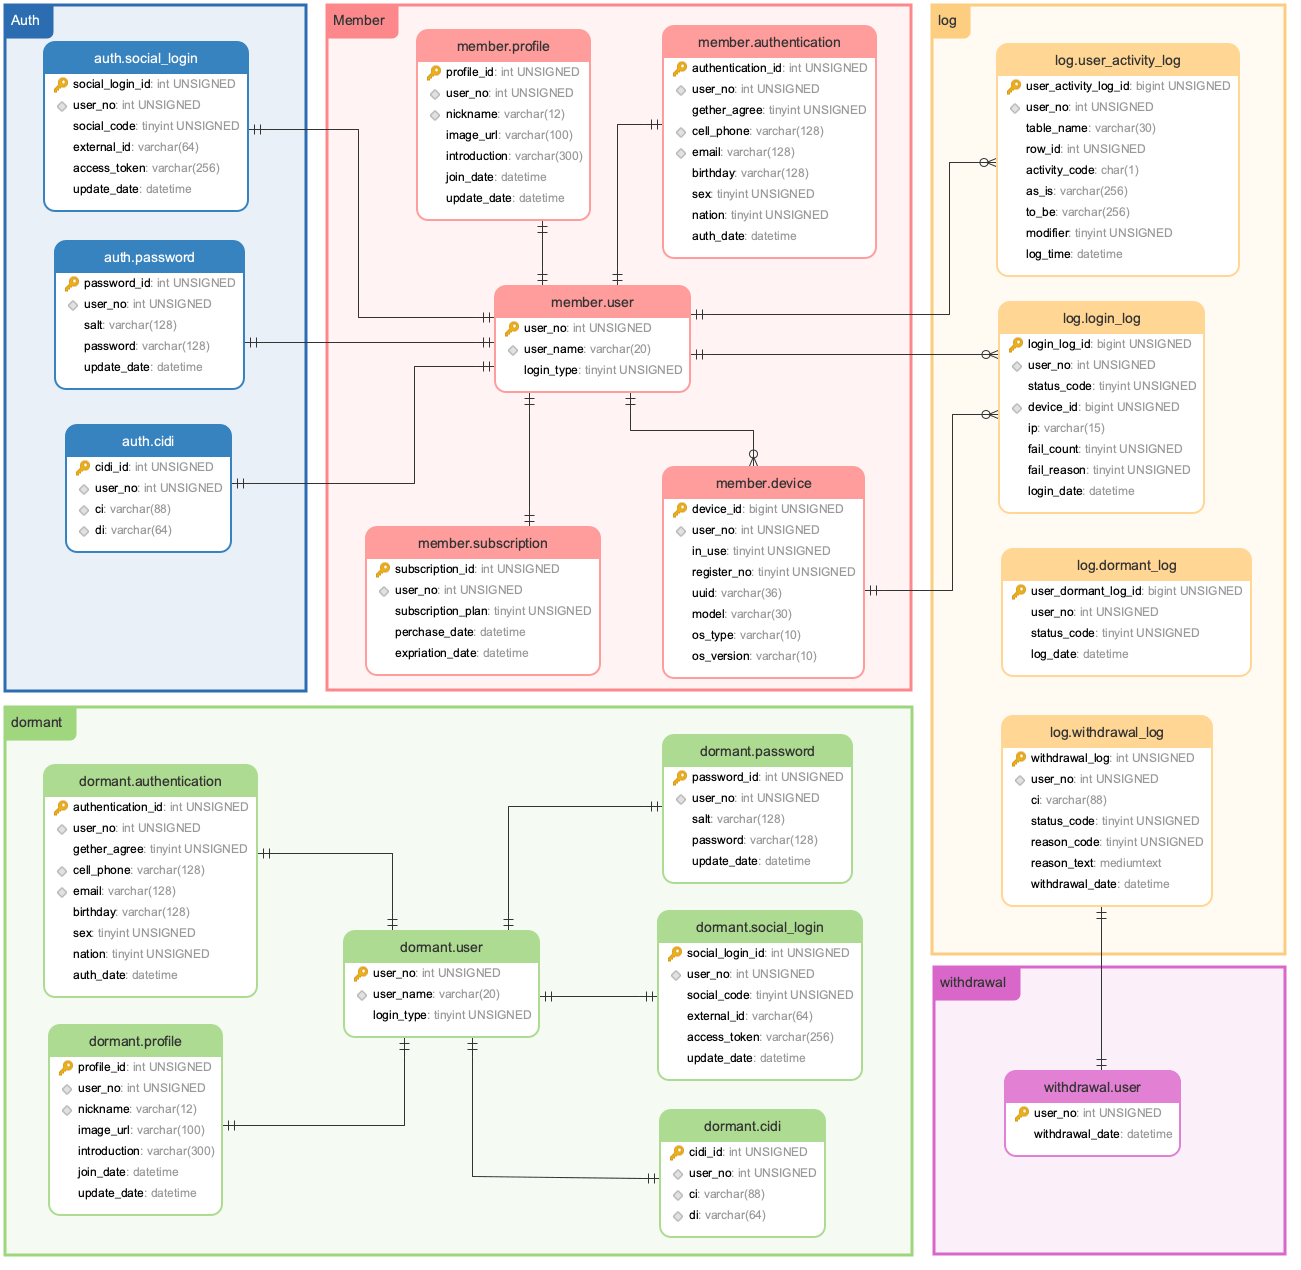
MySQL 8.4 LTS를 기준으로 작성했고, 한 인스턴스 안에서 스키마 단위로 첫 번째 분리를 했습니다. ERD의 레이어 한 칸이 스키마입니다. MySQL 8.0은 2026-04-21부터 Oracle Sustaining Support 단계로 넘어갔으니, 새로 만드는 서비스라면 8.4 LTS 이상에서 시작합니다.
스키마로 나누는 첫 번째 이유는 권한입니다. SQL 인젝션 자체는 파라미터 바인딩으로 막는 것이고, 스키마 분리가 하는 일은 계정별 접근 범위를 갈라 사고가 났을 때 닿는 데이터를 줄이는 것입니다. 「개인정보의 안전성 확보조치 기준」 제5조도 업무 수행에 필요한 최소한의 범위로 권한을 차등 부여하라고 요구합니다. 두 번째 이유는 속성별로 나눠 두면 서비스 규모가 커졌을 때 스키마를 인스턴스로 떼어내 MSA까지 이어갈 수 있다는 점입니다.
member 스키마부터 살펴보겠습니다
member.user
- 가장 기본적인 회원 ID를 저장하는 방식인데,
user_name은 일반적으로 사이트나 서비스에서 회원 가입할 때 사용하는 ID라고 보시면 됩니다. - 로그인 ID에 유니크 인덱스를 걸 때는 콜레이션을 확인해야 합니다. MySQL 8.0 이후 기본값인
utf8mb4_0900_ai_ci는 호환 자모 분해형(ㄱㅏㄴㅏㄷㅏ)과 완성형(가나다)을 같은 값으로 판정합니다. Oracle은 UCA 표준 동작으로 보아 버그가 아니라고 처리했습니다. 한국어 전용 콜레이션은 없으니, 분해형 입력을 막을지 저장 전에 정규화할지는 애플리케이션에서 정해야 합니다. -
MySQL에서는
user_no를AUTO_INCREMENT로 순차 할당했습니다. Oracle과 PostgreSQL에서는 시퀀스를 쓰고, PostgreSQL은GENERATED ALWAYS AS IDENTITY컬럼이 표준 문법입니다.순차 번호 대신 UUID로 고유 식별 코드를 만드는 구성도 있습니다. 36자 문자열을 그대로 두지 말고
UUID_TO_BIN()으로BINARY(16)에 저장합니다. 시간 기반 UUID라면 두 번째 인자에 1을 주어 시간 하위·상위 부분의 순서를 바꿔 두면 연속 생성한 값이 인덱스에서 이웃하게 되고, 읽을 때는BIN_TO_UUID()로 되돌립니다. - 최소한의 데이터로 구성해 두면 휴면(dormant)으로 넘어가거나 탈퇴(withdrawal)할 때까지 어떤 update도 하지 않고, 계정 상태가 바뀔 때 delete만 하는 것으로 정리됩니다.
member.authentication
- 회원의 인증 정보를 담습니다. 암호화가 필요한 개인정보만 이 테이블에 모으는 구조이고, 나중에 배송지나 주소록이 필요해지면 그 테이블만 따로 암호화하면 됩니다.
- 암호화 대상은 항목 이름만으로 정해지지 않습니다. 「개인정보의 안전성 확보조치 기준」(개인정보보호위원회고시 제2026-9호) 제7조제2항은 이용자의 주민등록번호·여권번호·운전면허번호·외국인등록번호·신용카드번호·계좌번호·생체인식정보를 조건 없는 저장 암호화 대상으로 둡니다. 신용카드번호와 계좌번호가 이 목록에 있다는 점을 놓치기 쉬운데, 고유식별정보가 아니라는 이유로 결제·정산 테이블을 평문으로 두면 근거가 없습니다. 조문 좌표는 데이터 암호화에 정리해 두었습니다.
- 컬럼을 암호화하면 그 컬럼으로는 동등 비교 외에 검색·정렬·범위 조건을 쓸 수 없습니다. 암호화 대상을 한 테이블로 모으는 설계가 이 제약과도 맞습니다. 목록이나 통계 화면에 필요한 값은 연령대·지역 구분처럼 범주화한 파생 컬럼을 평문으로 따로 둡니다.
- 개인정보를 담는 이유는 서비스를 개선할 근거가 필요하기 때문입니다. 어떤 사용자가 있고 연령층과 성별 분포가 어떤지 같은 통계가 그렇습니다. 여기 담기는 정보는 본인 인증 서비스를 제공하는 타업체의 인증으로 가입하는 경우만 기록됩니다.
member.profile
- 사용자가 직접 등록하는 정보인데, 닉네임과 프로필 사진은 앱 서비스에서 자주 여기저기서 불려 다니는 데이터입니다.
- 나머지 컬럼은 자주 읽히지는 않지만, 회원 조회나 닉네임을 클릭했을 때 대체로 같이 보이는 데이터입니다.
member.subscription
- 요즘 앱 서비스는 구독 모델을 많이 쓰는데, 해당 사용자가 무료 이용자인지, 유료면 어떤 플랜인지 기록해 둡니다.
- 로그인할 때 세션 정보와 함께 캐싱해 두면 처리가 빨라집니다. 세션 정보는 Redis나 Valkey 같은 캐시에 두는 편이 좋습니다.
member.device
- 사용자가 로그인하는 기기 정보를 담습니다. 어떤 기기가 많이 들어오는지 통계를 모으고, 사용자별 기기 대수를 제한하고, 인증되지 않은 기기의 사용을 막아 보안성을 높이는 것이죠.
그다음은 auth 스키마입니다
auth.password
- ID 방식으로 가입하면 password를 받습니다. 소셜 로그인과 ID 방식이 섞인 서비스에서 password를 user 테이블에 같이 기록하면 password가 null인 행이 생깁니다. 정규화로 이런 부분을 줄이고, 비밀번호 해시에 닿을 수 있는 계정을 따로 떼어 두기 위해 이렇게 분리합니다.
- 비밀번호는 복호화할 수 있는 형태로 저장하지 않습니다. 고시 제7조제1항 단서가 복호화되지 아니하도록 일방향 암호화하여 저장하라고 요구하고, 시행령 제30조제1항제4호 가목도 일방향을 명문으로 씁니다.
- 일방향이라고 아무 해시나 되는 것은 아닙니다. SHA 계열 같은 범용 해시는 빠른 것이 목적이라 대입 공격에도 그만큼 빠릅니다. 연산 비용을 조절할 수 있는 키 유도 함수를 쓰고, 솔트는 계정마다 다르게 생성해 해시와 함께 보관합니다. 반복 횟수는 기본값을 그대로 쓰지 말고 실제 서버에서 로그인 지연을 측정해 정하고, 하드웨어를 바꿀 때 다시 올립니다.
- 알고리즘 선택은 환경에 따라 좁아집니다. 공공 조달처럼 검증필 암호모듈이 요구되는 환경에서 검증대상 키 유도 함수는 KBKDF와 PBKDF이고 Argon2·bcrypt·scrypt는 그 목록에 없습니다. 민간 서비스에는 검증필 모듈 사용 의무가 없으므로 선택은 자유롭지만, 그 선택이 안전하다는 근거를 기록으로 남깁니다. ISMS-P 심사나 내부 감사에서 요구받는 것은 설정 화면이 아니라 이 기록입니다.
- 컬럼 폭은 넉넉하게 잡습니다. 해시 값과 솔트, 알고리즘과 반복 횟수 식별자가 함께 들어가고 알고리즘을 교체하면 길이가 또 바뀝니다.
auth.social_login
- 소셜 로그인 정보는 서비스 단위로 테이블을 나눌 필요 없이
social_code값으로 (1:apple, 2:google, 3:kakao, 4:naver …) 구분하고external_id를 기록하면 됩니다. 계정을 잇는 데 필요한 값은external_id입니다. - 액세스 토큰은 성격이 다릅니다. 유효기간이 짧고 갱신되는 자격증명이라, 회원 DB에 오래 들고 있을 이유가 있는지부터 따집니다. 소셜 서비스의 API를 대신 호출해야 해서 보관한다면 평문 컬럼으로 두지 않고, 만료나 연동 해지 시점에 지우는 경로까지 함께 설계합니다.
- 소셜 로그인으로 가입하면
user_no를 자동으로 생성하고user_name에 랜덤 ID를 부여하는 프로세스를 추가해야 합니다.
auth.cidi
- 휴대폰 인증이나 아이핀처럼 본인 인증 절차를 거쳤을 때 인증 업체로부터 받는 값입니다. CI는 법령 용어로 연계정보이고, 생성·처리는 「정보통신망 이용촉진 및 정보보호 등에 관한 법률」 제23조의5, 안전조치 의무는 제23조의6에 있습니다.
- CI는 어느 업체에서 인증을 받더라도 한 사람에게 하나의 값만 부여됩니다. 그래서 서비스 간 동일인 판정에 쓸 수 있고, 같은 이유로 한번 유출되면 되돌릴 수 없습니다.
- DI는 사이트 중복 가입을 방지하는 데 쓴다고 하는데, 인증 업체마다 다른 값이 올 수도 있기 때문에 사용하는 데 주의가 필요합니다.
- 연계정보는 시행령 제19조가 정하는 고유식별정보 네 가지(주민등록번호, 여권번호, 운전면허의 면허번호, 외국인등록번호)에 들어가지 않고 고시 제7조제2항의 조건 없는 암호화 대상 목록에도 없습니다. 그래도 제23조의6이 안전조치 의무를 따로 두고 있으니, 이 컬럼을 어떻게 보호할지는 판단과 근거를 남겨 둡니다. 주민등록번호로 대신하는 선택은 정보통신망법 제23조의2가 사용을 제한합니다.
휴면(dormant) 스키마입니다
- member 스키마의 오브젝트에 특별한 FK를 가지고 있지는 않지만 스키마 이상으로 떼어 두는 편이 낫습니다. 휴면에 빠진 회원 정보는 member에서 delete하고 기존 값을 그대로 dormant로 옮깁니다. member뿐만 아니라 auth의 데이터도 함께 옮겨 휴면 회원의 데이터는 전부 한곳에 자리하게 됩니다.
- 다만 휴면 분리 자체를 법정 의무로 적어 두면 근거가 어긋납니다. 일정 기간 접속하지 않은 이용자의 개인정보를 자동으로 삭제하게 했던 유효기간제는 구 정보통신망법 제29조에 있었고 2020-02-04 개정으로 삭제됐습니다. 현행에서 보유기간과 파기를 정하는 조문은 개인정보 보호법 제21조입니다. 보유기간이 지나거나 처리 목적을 달성해 불필요해진 개인정보는 지체 없이 파기하고, 다른 법령에 보존 의무가 있는 항목만 예외로 남기되 그때는 다른 개인정보와 분리하여 저장·관리합니다. 분리 보관을 스키마 분리로 구현하는 근거가 이 단서입니다.
- 휴면 스키마로 옮겨온 시점부터 회사 정책에 따라 1년, 3년, 5년 등의 단위로 복구하지 않는 회원을 공지와 함께 자동 탈퇴 처리하는 프로세스를 가지게 됩니다. 이 기간은 법령이 정한 값이 아니라 정책 값이므로, 처리방침에 공개한 보유기간과 파기 배치 주기가 서로 맞는지 대조합니다.
탈퇴(withdrawal) 스키마입니다
- 탈퇴한 회원의 개인정보를 계속 보유할 근거는 사전 통보가 아니라 다른 법령의 보존 의무입니다(법 제21조). 환불 고지에 필요한 연락처처럼 남겨야 하는 항목이 있다면 근거 법령과 보존 기간을 항목별로 적어 두고, 나머지 개인정보와 분리해 저장·관리합니다.
- 탈퇴한 회원이 재가입해 가입 시에만 받는 혜택을 중복으로 받지 않도록 CI를 일정 기간 보관하는 구성도 씁니다. 이때도 보관 기간과 근거를 먼저 정하고, 기간이 지나면 지우는 배치를 함께 만듭니다.
is_deleted = true같은 플래그는 파기가 아닙니다. 시행령 제16조제1항은 전자적 파일 형태의 개인정보를 복원이 불가능한 방법으로 영구 삭제하라고 정합니다. 논리 삭제로 운영한다면 물리 삭제나 복원 불가 처리로 넘어가는 후속 단계를 따로 둡니다. 파기 범위에서 자주 빠지는 곳은 백업본, 리드 레플리카, 바이너리 로그, 개발·스테이징으로 복사한 덤프입니다.- 탈퇴는 서비스에 따라 구성 내용이 많이 바뀌기 때문에 오브젝트를 구성하지 않았고, Billing 테이블이나 CI를 별도로 남기는 테이블을 구성하거나 withdrawal 테이블에 컬럼으로 기록할 수도 있습니다.
Log 스키마의 오브젝트를 보면 기존 테이블과 구성이 다릅니다
- 로그를 설계할 때 많은 개발자가 실수하는 부분이 테이블의 row 값을 그대로 복사해서 날짜만 붙이는 것인데, 로그의 설계 원칙은 모두 코드값으로 표현하는 것이 기본입니다. 코드만 보고 어떤 행동이 어떻게 발생했는지 알 수 있어야 합니다.
- 데이터 중복을 만드는 것보다 행위의 결과와 원인을 나타내는 것을 기본으로 해야 합니다.
- 서비스 행위 로그와 개인정보처리시스템의 접속기록은 목적이 다르므로 같은 테이블에 섞지 않습니다. 접속기록의 보관 기간은 고시 제8조가 정하는데, 기본은 1년 이상이고 5만명 이상 정보주체의 개인정보를 처리하거나 고유식별정보·민감정보를 처리하는 시스템은 2년 이상입니다. 기준이 바뀌면 보존 기간이 두 배가 되니 월 단위 파티션에 드롭 정책을 걸어 두면 정책 값만 고치면 됩니다. 관련 조문은 데이터 3법에 모아 두었습니다.
앱 서비스에 필요한 기본적인 테이블 설계로 1:1 매칭 데이터가 어떤 속성을 가지고 분리되는지, 위 ERD 모델을 보고 천천히 분석해 보면 테이블 모델링이 조금은 이해되지 않을까 해서 그려 봤습니다.
만 14세 미만 아동의 법정대리인 동의나 성인 인증이 필요한 경우를 저 모델의 어디에 어떻게 추가할지 스스로 고민해 보시면, 앞으로 새로운 설계를 하는 데 많은 도움이 될 것이라 생각합니다.
1:1 정규화로 조인해야 하는 테이블 간 블록 읽기를 최소화하면 데이터 출력 속도도 빠르게 유지할 수 있고, 속성별로 테이블을 분리했기 때문에 적재적소에 필요한 컬럼이나 별도의 테이블을 추가해서 서비스를 늘려가는 것이 어렵지 않습니다.
테이블정의서를 첨부합니다.